胡杨
清华大学集成电路学院教授;长江学者
晶圆级 AI 系统只有在短距互连、拓扑、热图与故障调度转化为持续有效 Token goodput——而不是峰值 FLOPS——时才站得住
“晶圆级路线的目标不是追求一个更大的峰值算力数字,而是通过架构、互连、集成、容错、散热和数据中心网络协同,改善完整系统的持续Token产出与成本。”
引用来源:新架构AI芯片生态论坛|2026-10-22 下午|报告题目:《晶圆级芯片——面向Token经济性的全系统协同设计》 · 论坛日程
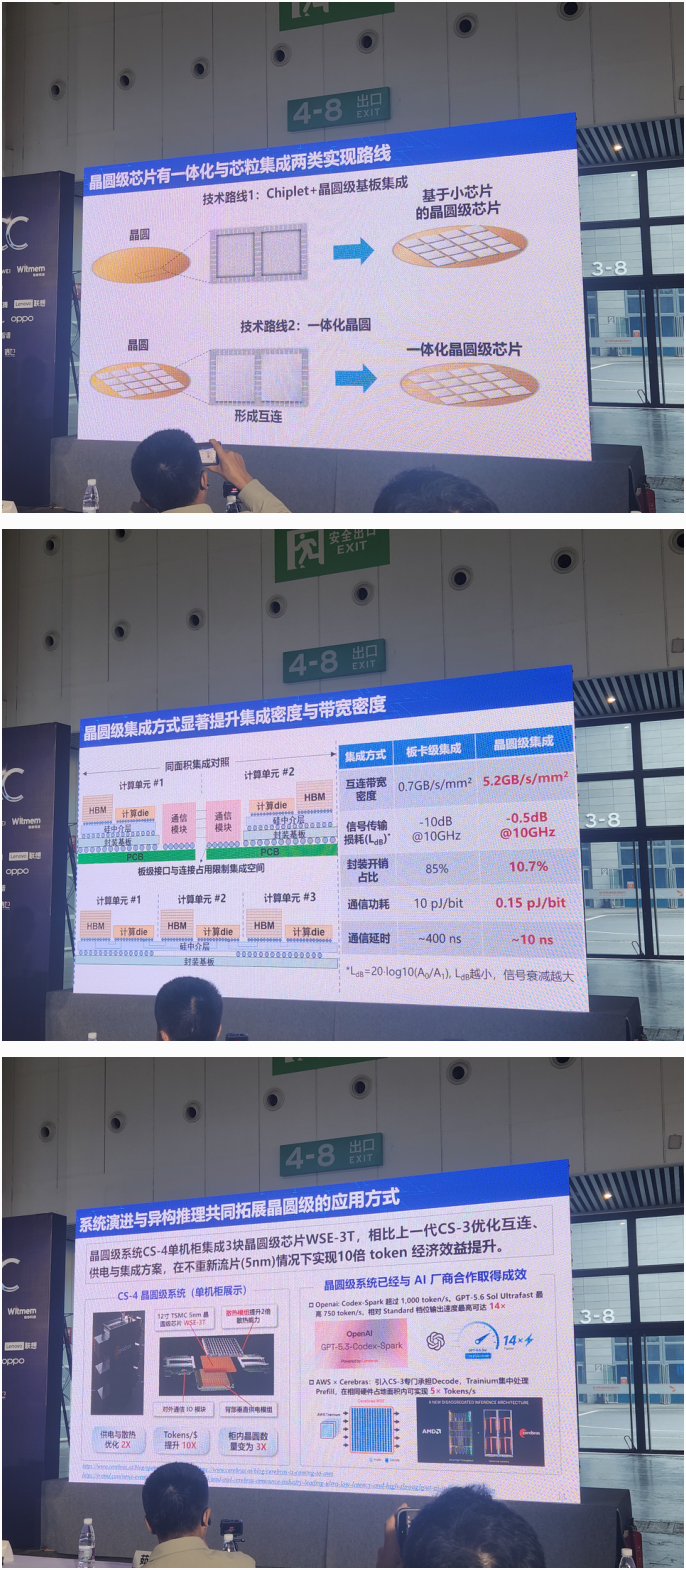
算力供给怎么记账/验收:从峰值 FLOPS,转向数据路径、热与可用性约束下的持续有效产出。
清华大学集成电路学院教授;长江学者
晶圆级 AI 系统只有在短距互连、拓扑、热图与故障调度转化为持续有效 Token goodput——而不是峰值 FLOPS——时才站得住
“晶圆级路线的目标不是追求一个更大的峰值算力数字,而是通过架构、互连、集成、容错、散热和数据中心网络协同,改善完整系统的持续Token产出与成本。”
引用来源:新架构AI芯片生态论坛|2026-10-22 下午|报告题目:《晶圆级芯片——面向Token经济性的全系统协同设计》 · 论坛日程
新架构控制点上移到公共语义+运行时选择+持续验证——动态硬件上编译期定不全,开放运行时栈来选择并验证。
北京智源人工智能研究院 · 编译及架构(博士)
开放 AI 软件栈通过动态选择并缓存 FlagGems、版本化内核与运行时路径,降低异构部署风险
“插件采用更务实的选择机制:动态加载并搜索FlagGems、厂商原生算子和第三方库中的可用实现;针对当前平台与算子尝试、判断更合适者;执行成功后缓存选择结果,供后续复用。”
引用来源:新架构AI芯片生态论坛|2026-10-22 下午|报告题目:《FlagOS:让每一颗芯片说同一种语言》 · 论坛日程
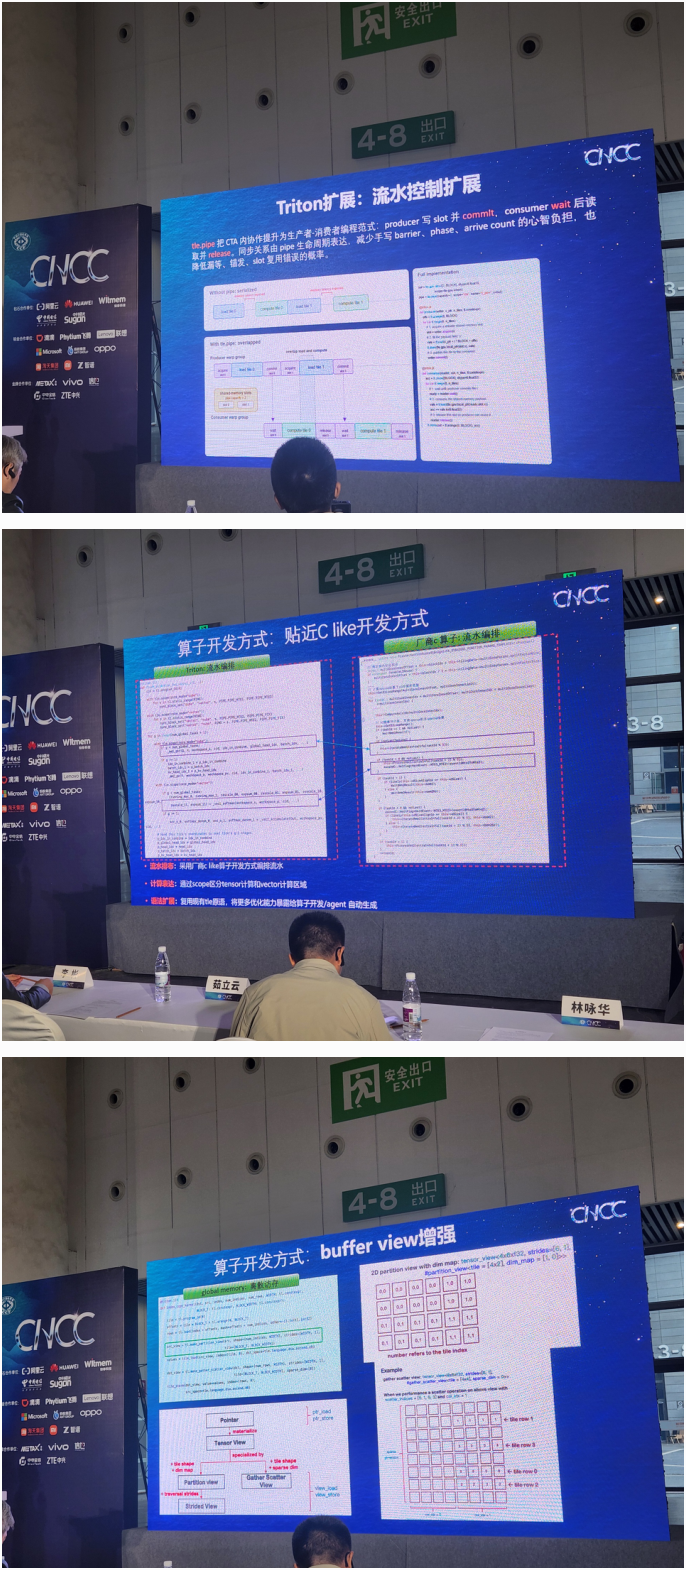
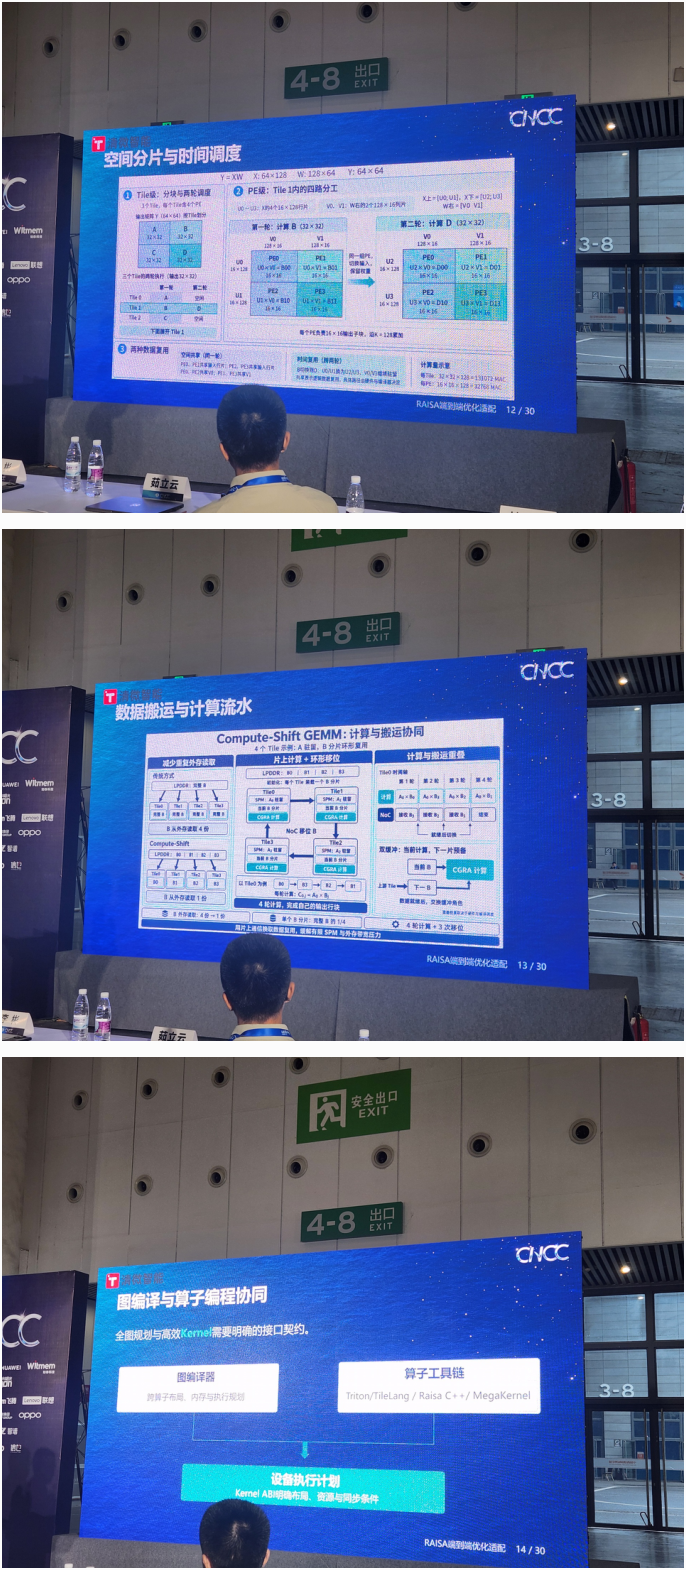
清微智能研发VP
动态 shape、KV 状态与并发,使编译期多版本加上带缓存的运行时选择成为可重构/3D 硬件上的控制点
“编译期状态不完整:图依赖、资源约束和shape上界可能已知,但实际Token上下文、KV Cache、并发/batch、激活和中间结果驻留往往到运行时才明确。——RAISA把编译期、warm-up与运行期连成自适应闭环。”
引用来源:新架构AI芯片生态论坛|2026-10-22 下午|报告题目:《面向可重构计算的端到端全栈优化适配技术(Open3D-PIMC开源实践)》 · 论坛日程
存算产品化:从阵列能效,转向 KV/主存语义、隔离合同与整机资格。
OPPO 技术规划专家
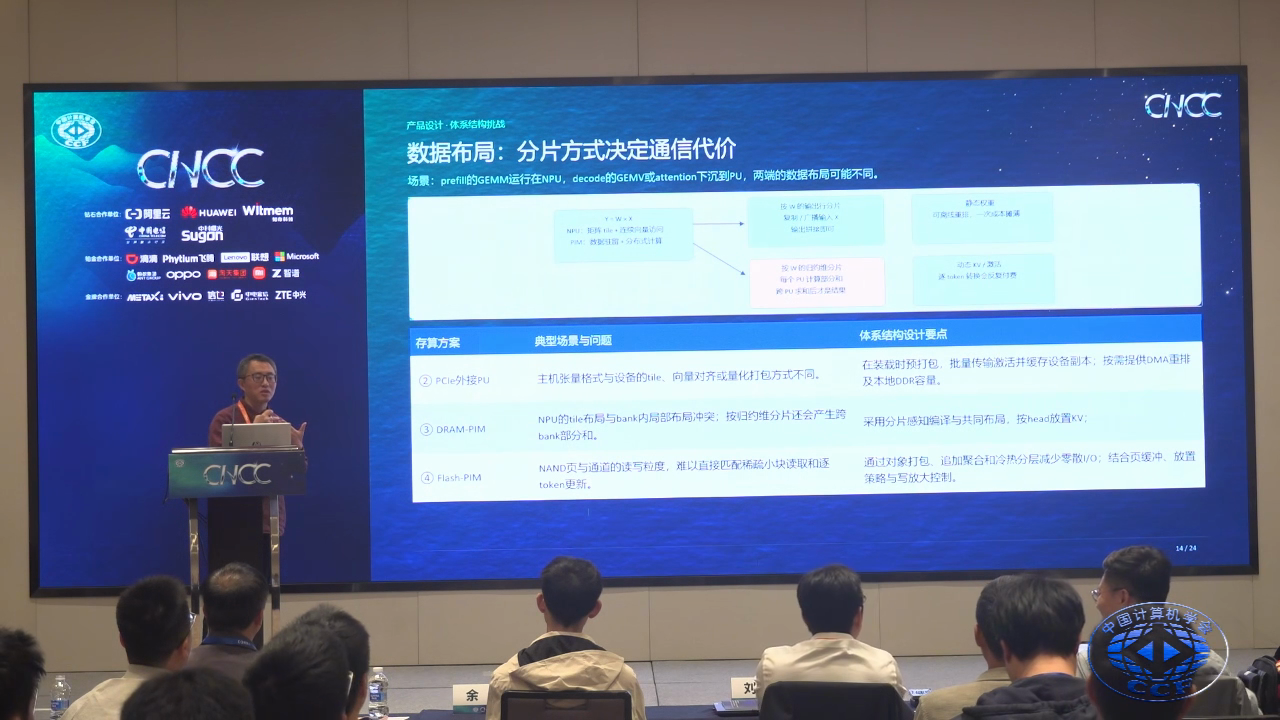
Prefill 上 NPU、Decode 上 PIM 只有在 KV 写完成、地址交织、布局与隔离合同齐备后才可采纳
“最简单的一个场景就是说做这个NPU把这个prefill把KV cache要写到DRAM里面去。但是PIM做decoding的时候,他不知道这个数据什么时候写完的,写到哪里,写到哪些数据有更新呢?那当前是没有一个非常好的或者统一的一个硬件机制的去解决这些问题……地址映射:SOC要做交织,PIM不喜欢交织——对OS来说就是个非常大的问题。”
引用来源:端侧智能的算力破局:存算一体论坛|2026-10-23 下午|报告题目:《终端产品对端侧大模型的需求与挑战》 · 论坛日程
上海交通大学计算机学院研究员
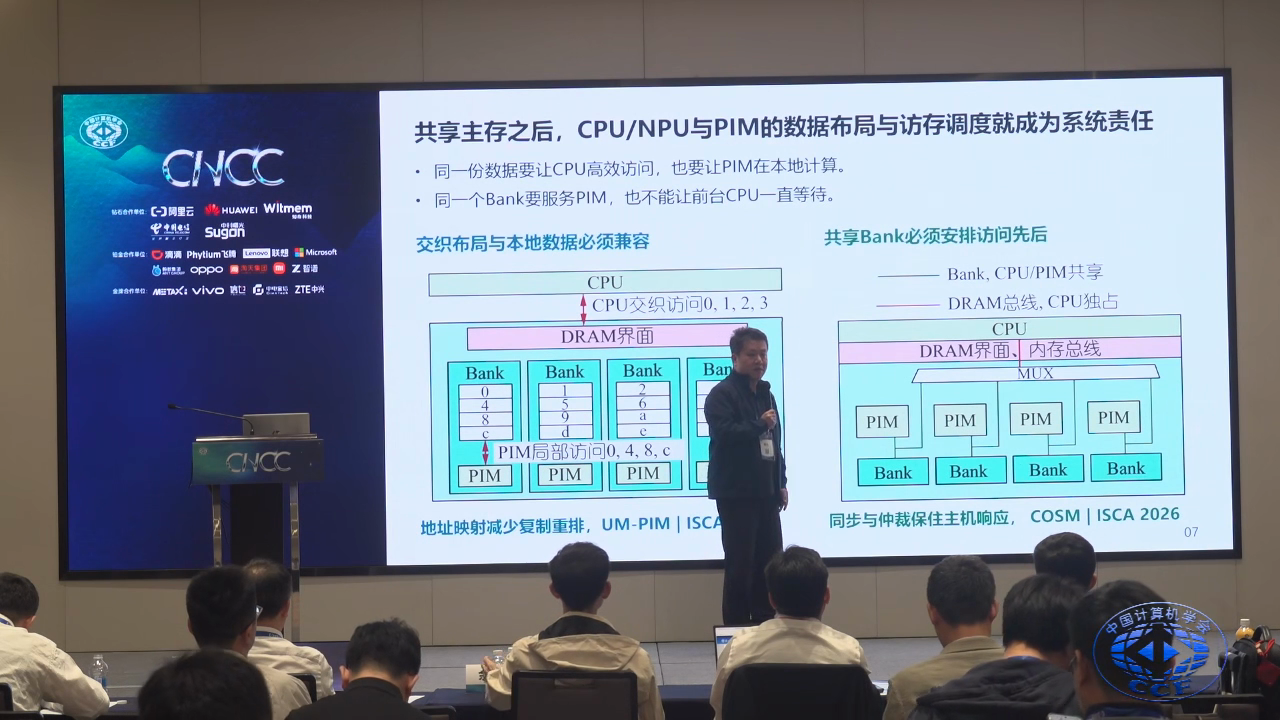
共享主存 PIM 的收益受 CPU 重映射、bank 内局部连续性与可抢占仲裁约束
“我认为存算一体要和现有的主存要兼容……共享主存之后有两个挑战……CPU对于数据的排布和PIM对数据排布的要求是不一样的……同一个memory的bank……必须要决定这两个master谁来访问他。”
引用来源:端侧智能的算力破局:存算一体论坛|2026-10-23 下午|报告题目:《端侧大模型时代重新思考存算一体的位置》 · 论坛日程
智存控制:从增加层级,转向 KV/Tensor 的位置、版本、生命周期与复用语义。
哈尔滨工业大学(深圳)教授;教育部青年长江学者
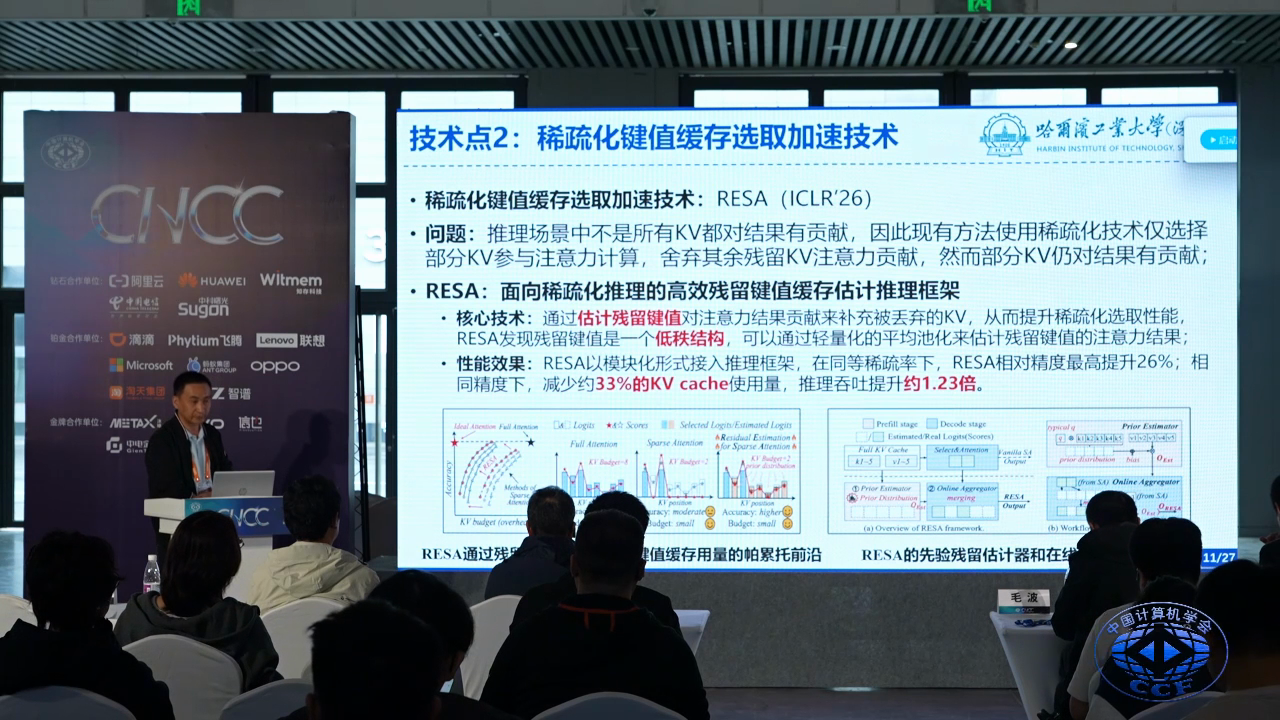
按多层注意力影响对重复 RAG 文档做选择性重算,可比全量重算更省——但须先扣除缓存加载与错误复用成本
“重复文档不必整段重算:先看多层注意力里哪些 token 真被下游用到,再决定缓存命中还是局部重算。”
引用来源:智存融合—大模型存储技术论坛|2026-10-24 下午|报告题目:《面向智存融合场景的高效能存储技术研究》 · 论坛日程
端侧模型设计:从缩小云模型,转向训练、编码、架构与 NPU 执行的联合约束。
OPPO AI 中心端侧算法组负责人
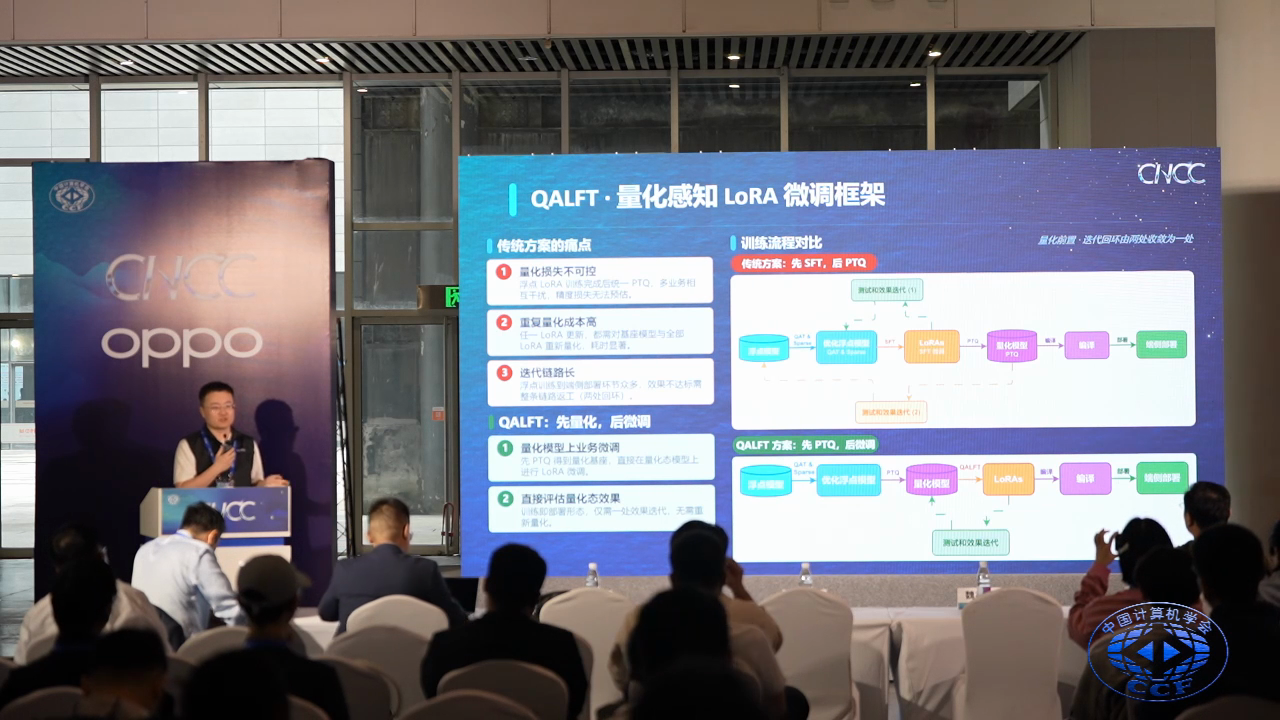
固定量化基座并在其上训练按业务 LoRA,可使产品更新与全量重新量化解耦
“量化模型与浮点模型的 Top-1 token consistency 达到 95% 以上……QALFT:先量化,后微调——先 PTQ 得到量化基座,直接在量化态模型上进行 LoRA 微调……任 LoRA 更新都需对基座与全部 LoRA 重新量化的痛点被消除。”
引用来源:手机端侧大模型技术演进与产业化路径论坛|2026-10-22 下午|报告题目:《OPPO端侧计算实战》 · 论坛日程
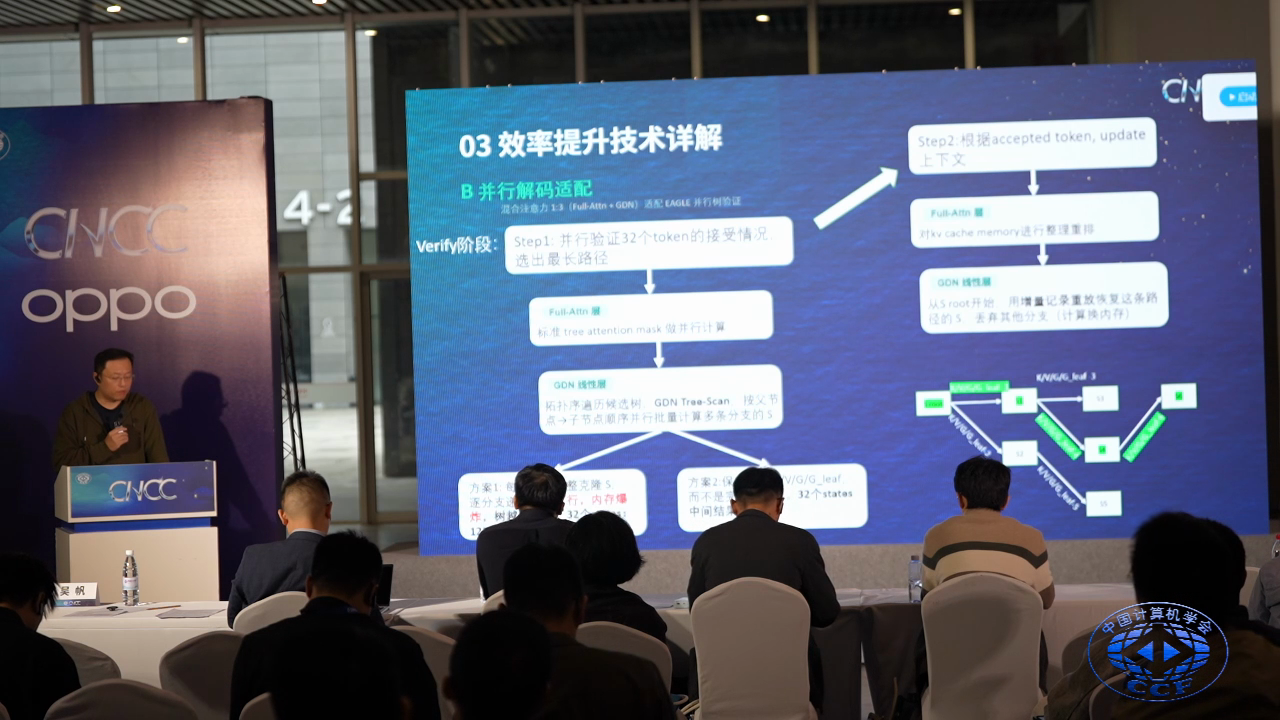
OPPO 端侧推理加速组技术负责人
混合注意力上的树式推测解码,须沿接受路径重放线性注意力的 recurrent state
“混合注意力架构上做并行解码适配:Full-Attn 层用 tree attention mask 一次并行验证;GDN 线性层 states 有时序依赖,须按接受路径重放/恢复 recurrent state,而不能直接套用 potential 的 tree mask。”
引用来源:手机端侧大模型技术演进与产业化路径论坛|2026-10-22 下午|报告题目:《端侧AI 推理加速:从技术突破到产品落地》 · 论坛日程
清华大学计算机系研究员;面壁智能大语言模型首席科学家
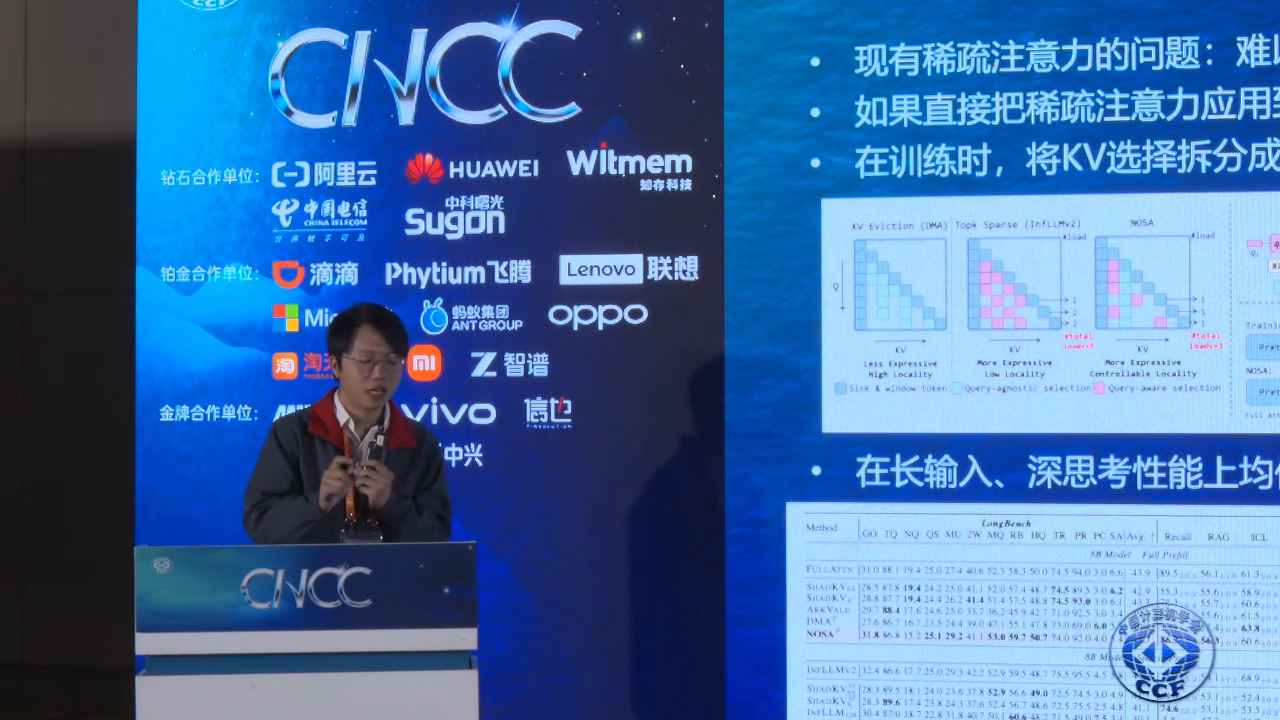
忽略 Decode 期 KV 局部性的稀疏注意力,会把算力收益变成通信损失;模型侧须同时训练访问局部性
“现有稀疏注意力……如果直接把稀疏注意力应用……在训练时,将 KV 选择拆分成……High Locality / Low Locality……我们发现其实它最大的一个瓶颈在于这个访存的局部性它是不够的。”
引用来源:第三届端侧大模型论坛:定义端侧通用人工智能|2026-10-22 下午|报告题目:《高能力密度大模型的高效构建》 · 论坛日程
端侧推理优化:从 NPU 前向加速,转向覆盖 CPU 采样、拷贝与后处理的完整产品流水线。
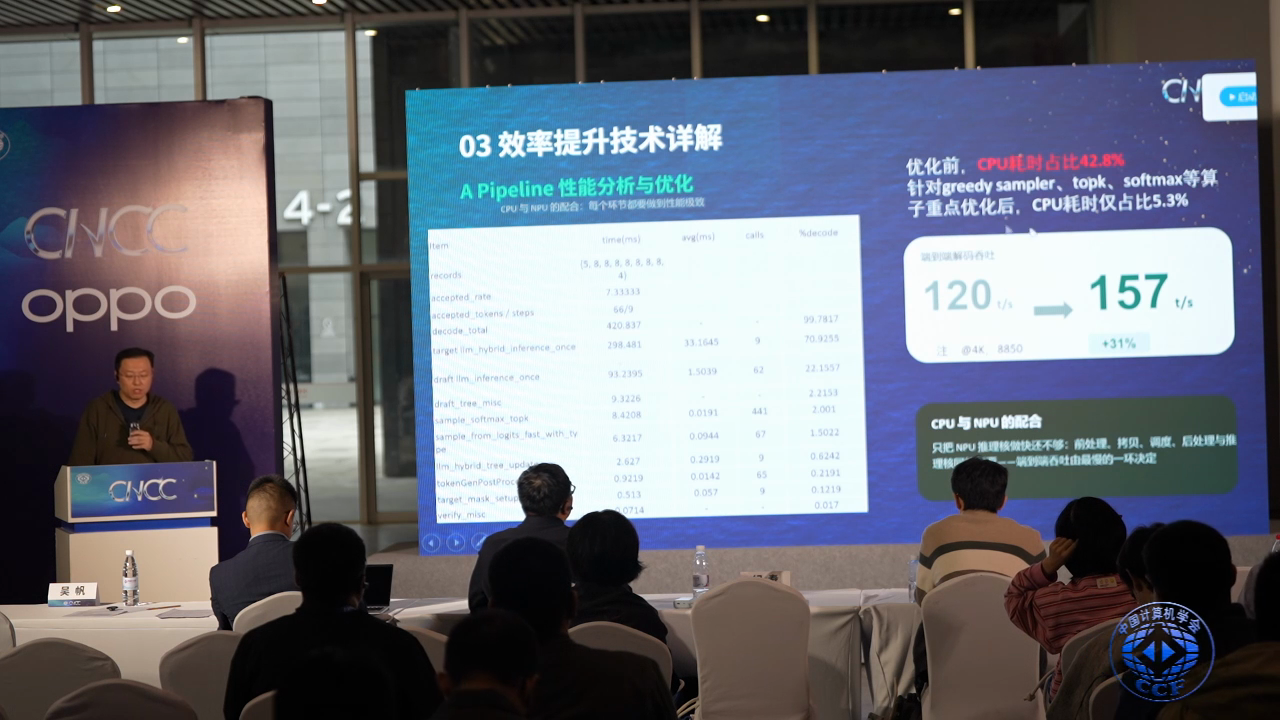
OPPO 端侧推理加速组技术负责人
只优化 NPU kernel 的端侧 Decode 加速会错过控制点——当 CPU sampler/top-k/softmax/拷贝/后处理成为剩余瓶颈时
“观察一:瓶颈不只在 NPU 的模型前向计算。……我们会针对像一些特别的后处理的算子,像 greedy sampler,然后还有 top k soft max 等算式平台的一些重点优化。也看到就是 CPU 的耗时最后优化到整个占比到 5.3%。”
引用来源:手机端侧大模型技术演进与产业化路径论坛|2026-10-22 下午|报告题目:《端侧AI 推理加速:从技术突破到产品落地》 · 论坛日程
端云协同:从请求分流,转向设备状态校准的 OS 路由、端云状态平面与隐私边界。
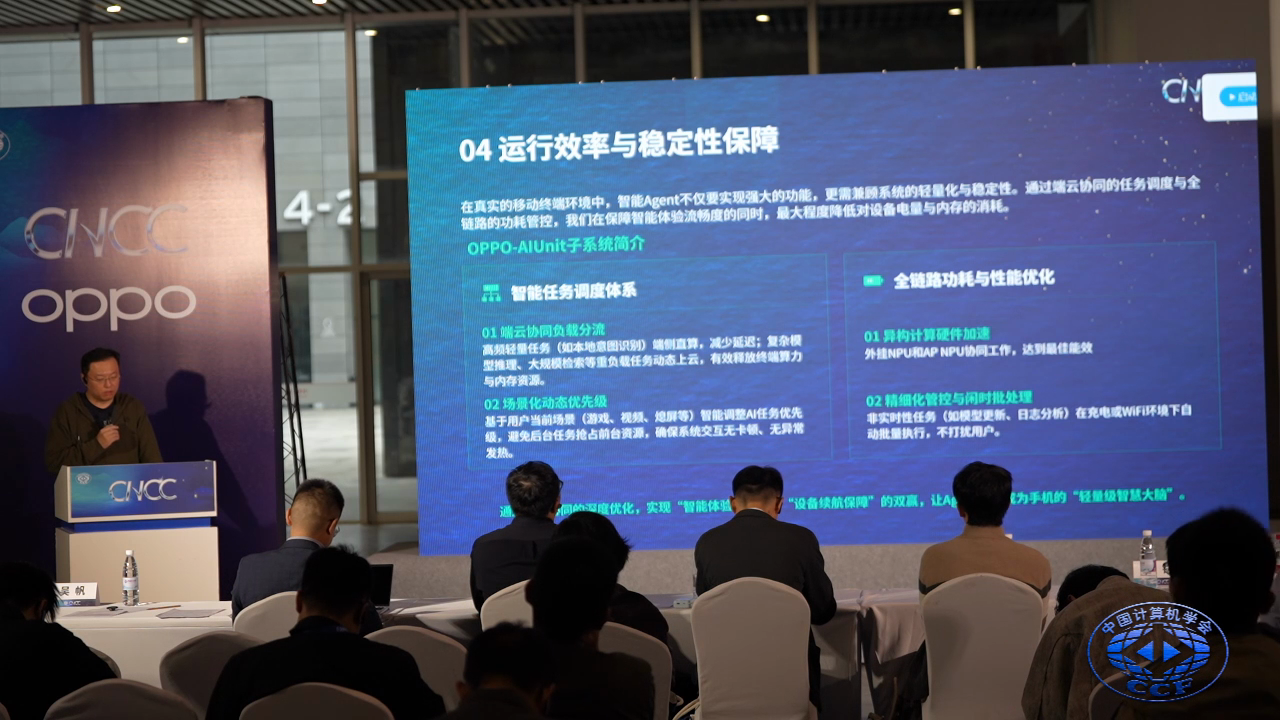
OPPO 端侧推理加速组技术负责人
端云推理路由应落在以温度、前台负载与充电状态为输入的 OS 状态机中
“通过端云协同的任务调度与全链路的功耗管控……高频轻量任务留端直算……复杂模型推理、大规模检索等重负载任务动态上云……基于用户当前场景(游戏、视频、熄屏等)智能调整 AI 任务优先级。”
引用来源:手机端侧大模型技术演进与产业化路径论坛|2026-10-22 下午|报告题目:《端侧AI 推理加速:从技术突破到产品落地》 · 论坛日程
上海交通大学计算机学院教授
分布式端云 RAG 可让敏感文档留端、公共文档留云——前提是词表/分布对齐与聚合协议成立
“敏感文档留在端侧、公共文档留在云端,前提是词表与分布对齐,并且聚合协议本身站得住。”
引用来源:手机端侧大模型技术演进与产业化路径论坛|2026-10-22 下午|报告题目:《端云协同智能体系统》 · 论坛日程
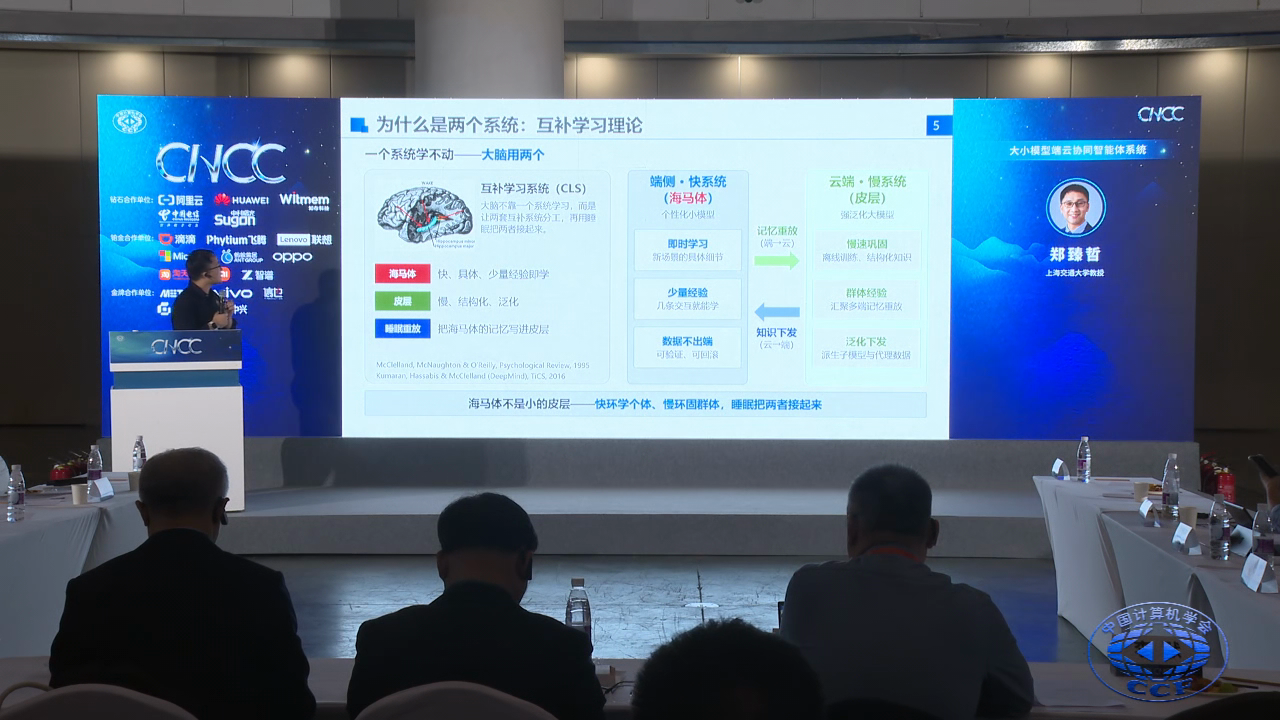
冻结视觉表征降本:从直接重训,转向诊断与后验归一化释放已有表征——不等于不再训练。
英国萨里大学教授
冻结视觉基础模型在重训前应先做各向异性诊断与后验归一化;任务局部微调收益不能泛化为普适控制点
“when you actually… do either total covariance or within class covariance… the performance improves a great deal……with simple extensions… which involves post Normalization, you can get as much as ninety three and a half percent… pretty close to what you can achieve with fine tuning.——冻结视觉基础模型在重训前应先做各向异性诊断与后验归一化。”
引用来源:22日上午大会特邀报告|2026-10-22 上午|报告题目:《Representation Similarity Analysis of Foundation Models in Deep Learning》 · CNCC2026官网
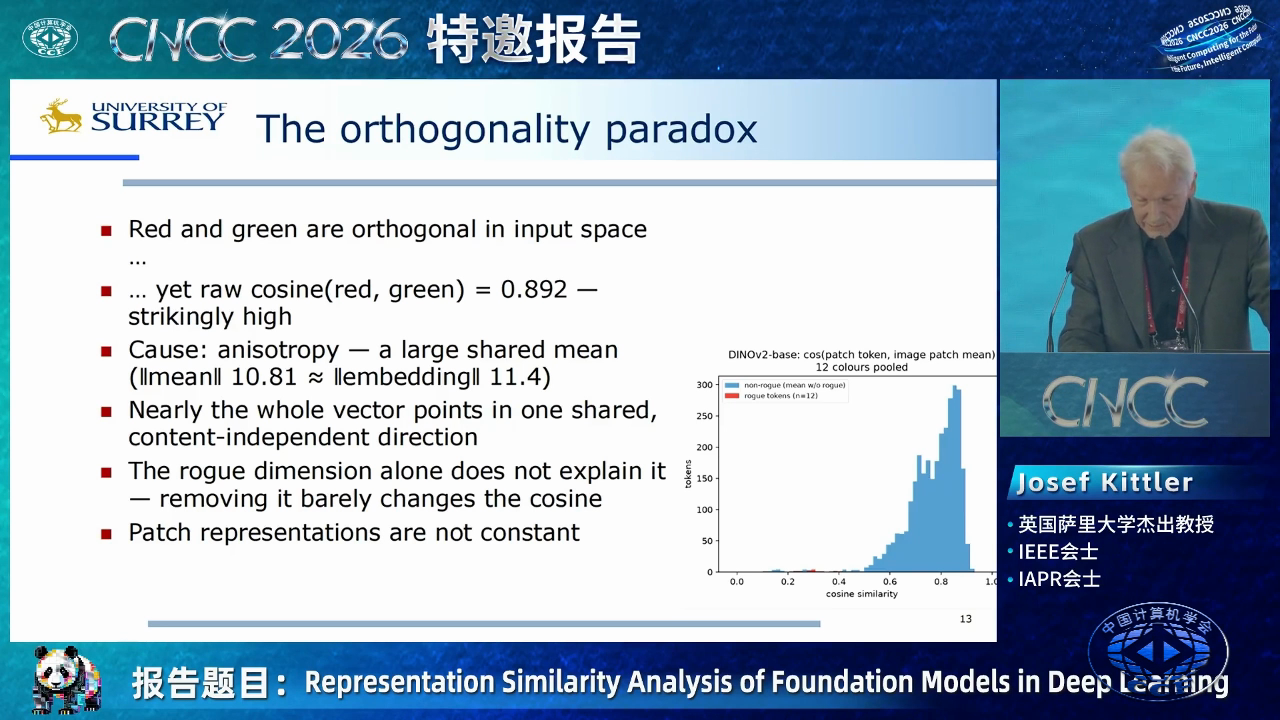
长程 Agent 运行:从临时会话,转向可恢复、可审计的持久任务。
华为终端首席专家
长程 Agent 运行时应以外置检查点、幂等、恢复与重放边界限制故障损失
“在传统架构上叠更强模型,改变不了命运——缺的不是智力,是生命支持系统。……长程任务需要外置检查点、幂等、恢复与重放边界:跑得久,也挂得回(四大机制+三大保障:状态检查/断点续跑/版本回滚)。”
引用来源:构建新一代操作系统AgentOS论坛|2026-10-24 下午|报告题目:《AgentOS:支撑智能体长程任务持续演进的原生操作系统底座》 · 论坛日程
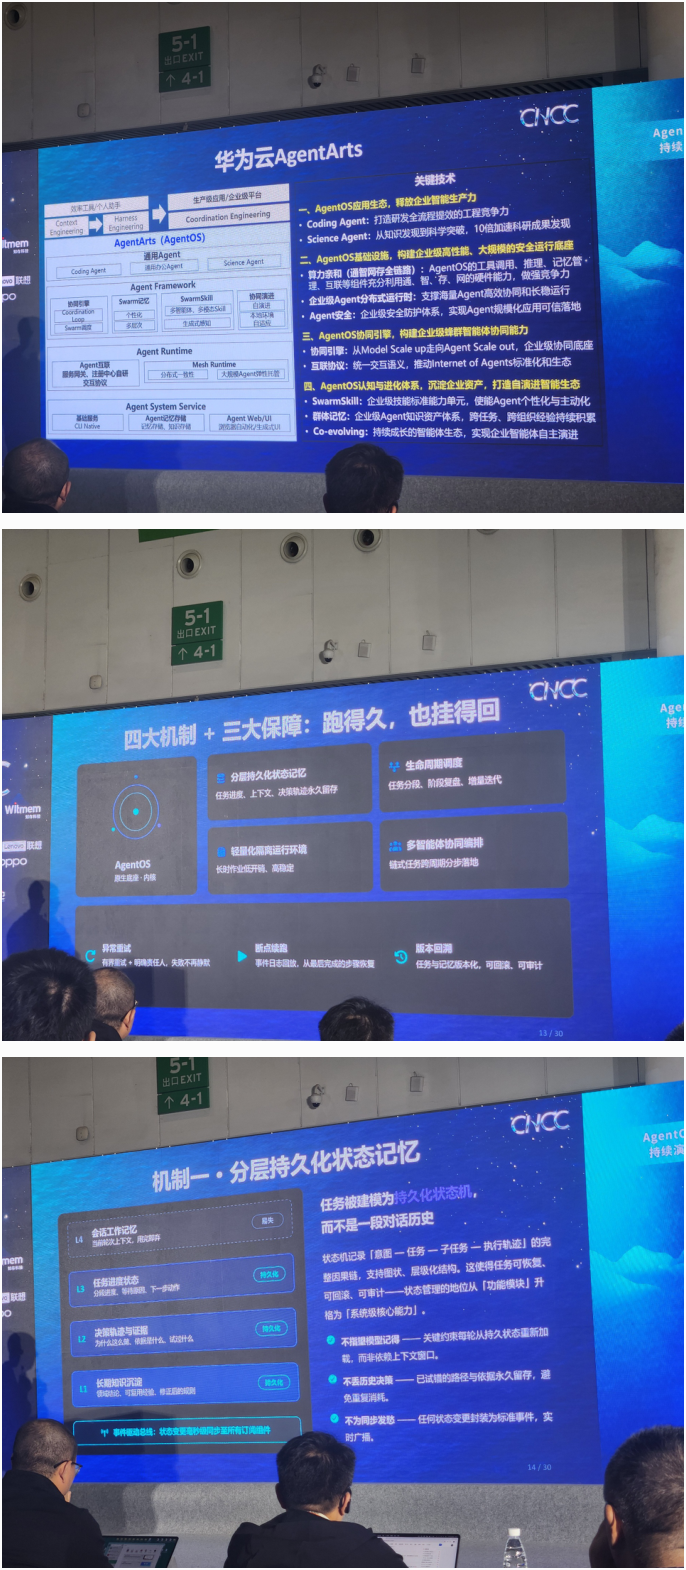
华为终端首席专家
Agent 生产准入应要求六项破坏测试——幂等、中途撤权、检索注入、写后中断、审批后改稿、重试耗尽——全部通过
“长程任务的失败是乘出来的,不是加出来的;提示词优化解决不了指数衰减——应把目标从「每步不犯错」转为「错了能接着跑」。可靠性是复利:单步95%串20步≈36%。生产准入需破坏测试覆盖幂等、中途撤权、检索注入、写后中断、审批后改稿、重试耗尽。”
引用来源:构建新一代操作系统AgentOS论坛|2026-10-24 下午|报告题目:《AgentOS:支撑智能体长程任务持续演进的原生操作系统底座》 · 论坛日程
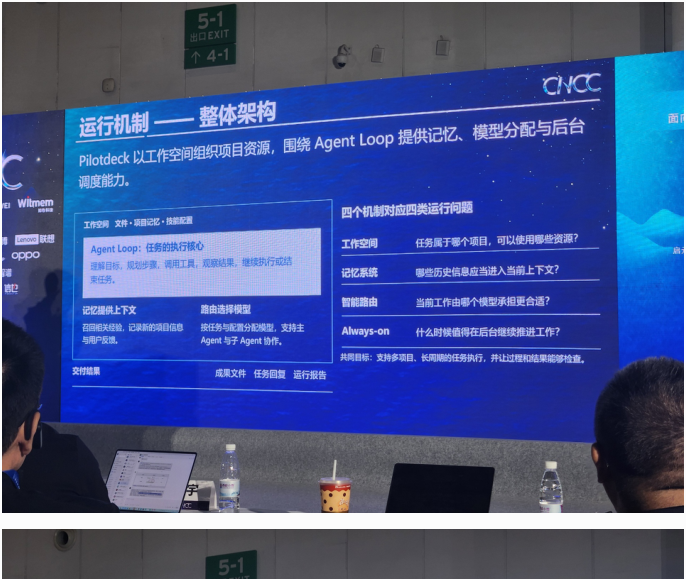
Agent 记忆:从拉长上下文,转向项目命名空间内可编辑、可纠错、可回滚的受控状态。
启元实验室大模型中心副研究员;清华 THUNLP 客座;PilotDeck / UltraRAG 负责人
白盒记忆只有在来源可编辑、错误可纠正、历史可回滚、跨项目偏好受控时才有意义
“共享聊天容器不是完整的 AI 生产环境;通用 Agent 仍困在连续会话里:成本不可控、上下文相互污染。”
引用来源:构建新一代操作系统AgentOS论坛|2026-10-24 下午|报告题目:《PilotDeck——面向生产力的智能体操作系统尝试》 · 论坛日程
Agent 工具供给:从静态适配,转向生成、注册、隔离执行与持续治理的生命周期。
北京大学;北京通明湖信息技术应用创新中心主任、理事长
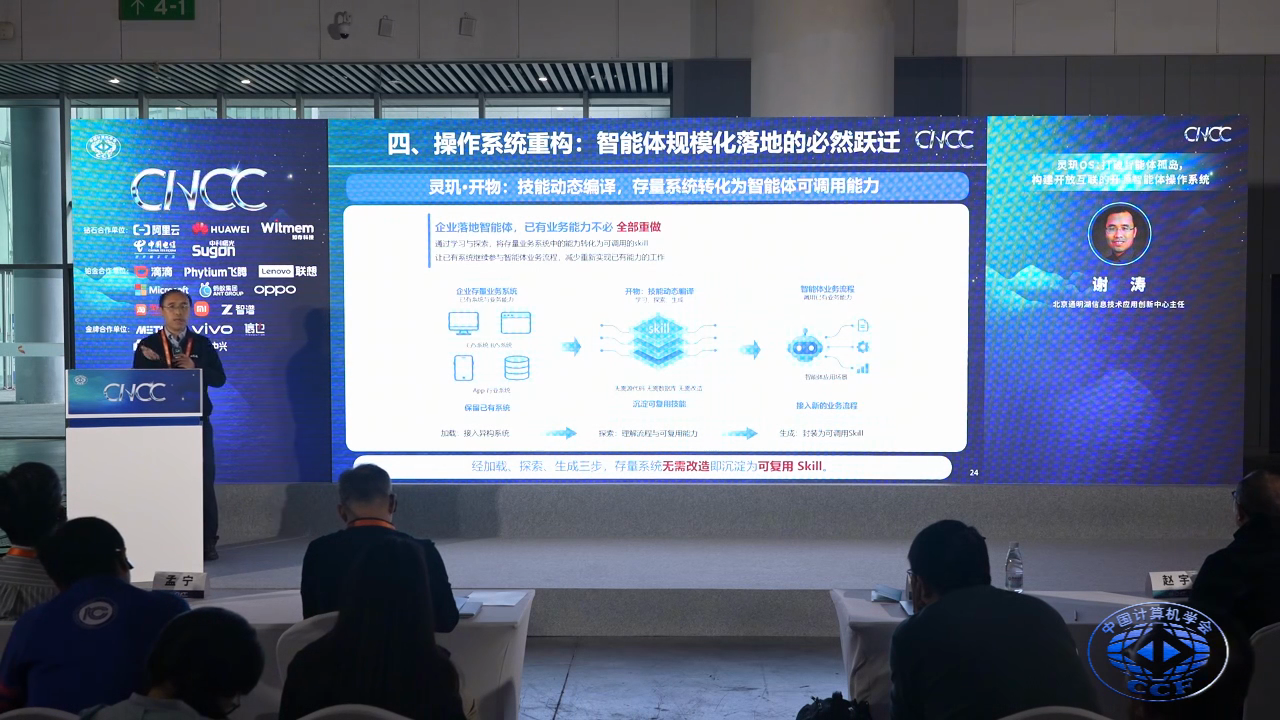
经 API 轨迹组合 Skill,或源码编译为 MCP/Skill,可缩短遗留软件的 Agent 接入路径
“临机开物……监控这个应用和操作系统的 API 调用的轨迹,通过这个轨迹进行组合,形成了跑的场景所需要调用的这个技能。……基于把有源代码的情况下,通过我们这个 MCP 编译器能够编译到 MCP 或 skill,由智能体接入。”
引用来源:构建新一代操作系统AgentOS论坛|2026-10-24 下午|报告题目:《灵玑OS:打破智能体孤岛,构建开放互联的开源智能体操作系统》 · 论坛日程
Agent 组织控制离开静态 DAG/自由长链两极,转向有边界的 Planner–Worker 与人在环路之上。
梦宁网络 CTO
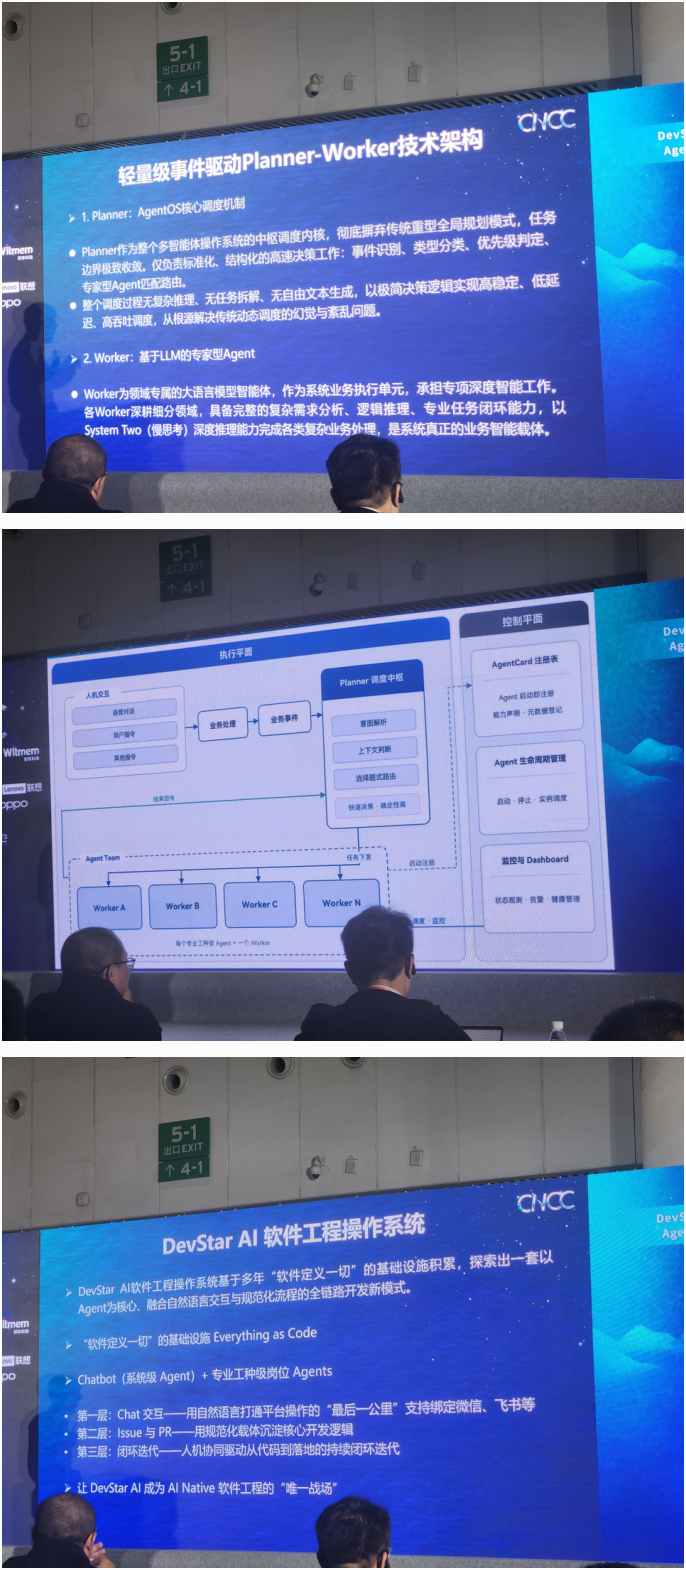
在收敛的业务 Agent 中,Planner 应解析意图、判断上下文并路由——而独立测评的 Worker 承接复杂闭环
“人机交互 → 业务事件 → Planner → Worker 团队 → 结果回传——Planner 解析意图并路由,而不是让独立测评的 Worker 自行扩权。”
引用来源:构建新一代操作系统AgentOS论坛|2026-10-24 下午|报告题目:《DevStar AI在软件工程领域AgentOS上的探索与实践》 · 论坛日程
中国人民大学高瓴人工智能学院预聘副教授
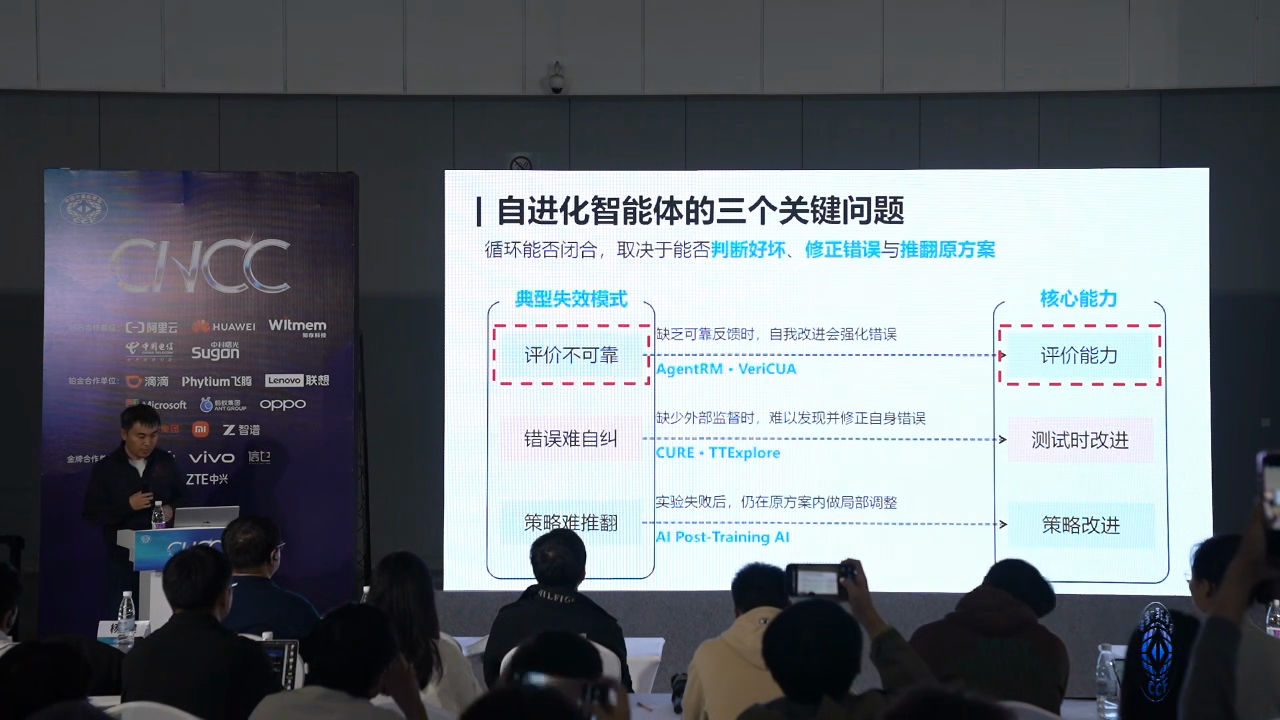
最终分更高不等于自我改进;训练策略从未改变的轨迹,即使榜单数字上升,也证伪 Agent-RL 改进主张
“如果一条轨迹从头到尾从未改过训练策略,即便榜单分数升高,也不能把它写成自我改进成功。”
引用来源:大模型智能体强化学习与自进化论坛|2026-10-24 下午|报告题目:《智能体离真正的自我改进还差什么》 · 论坛日程
后训练数据产品:从静态答案,转向 Environment+Verifier+Expert Trajectories。
清华大学计算机系;智谱 AI 首席科学家
后训练数据产品应交付为 Environment + Verifier + Expert Trajectories,并以机器任务与失败恢复验收
“认认真真做后训练:环境、奖励、算法……新一代的数据标注交付物从「标注」变成了「环境+验证器+专家轨迹」。”
引用来源:23日上午大会特邀报告|2026-10-23 上午|报告题目:《从“对话”到“干活”——大模型时代的认知重塑:Scaling Correctness》 · CNCC2026官网
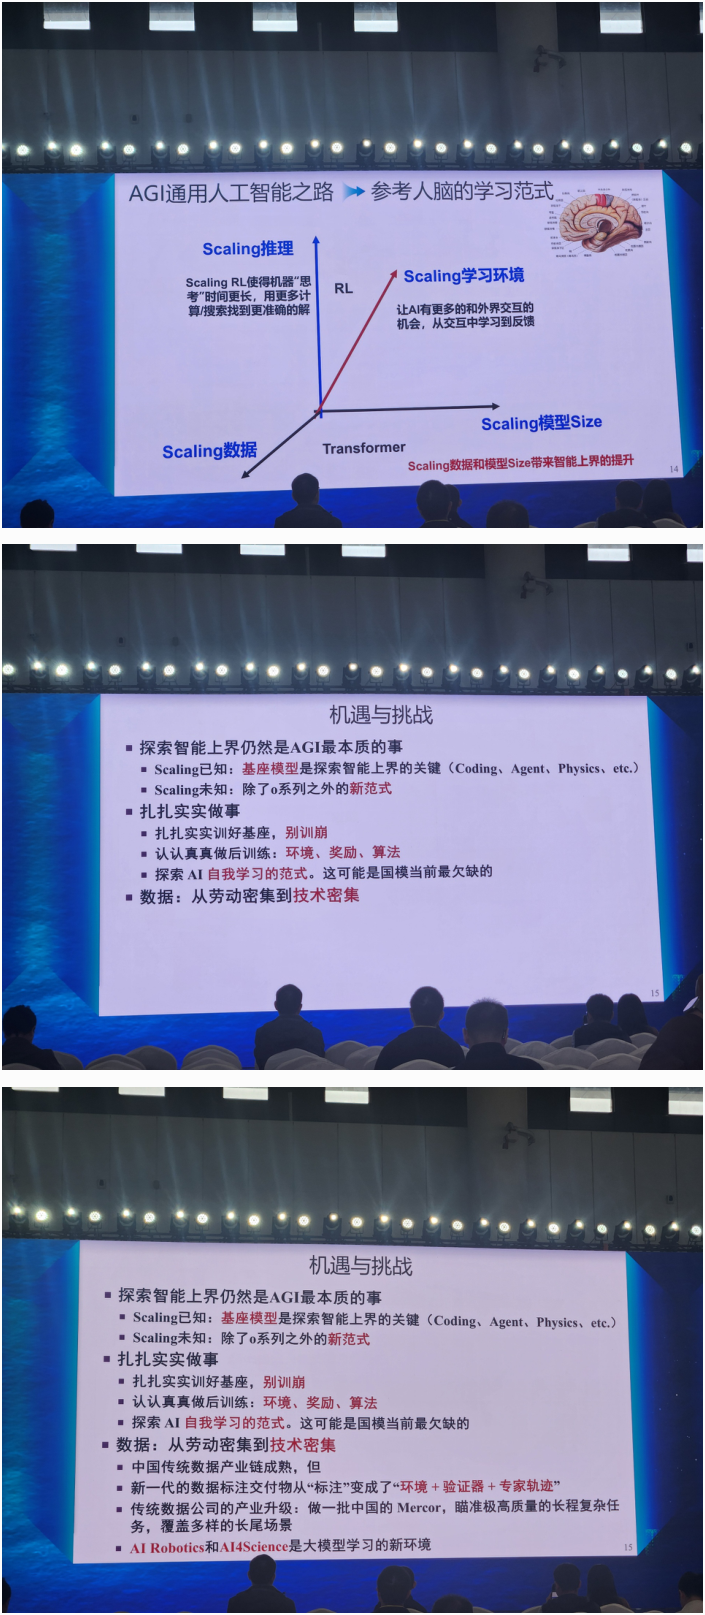
数据质量控制:从入库前清洗,转向执行失败的归因、分类修复、评测门禁与灰度上架。
数新智能(DataCyber)CEO
失败轨迹只有在归因、处置、评测门禁与灰度上架之后才成为资产——原始日志不是资产
“原始失败日志还不是资产;只有走过归因、处置、评测门禁和灰度上架,轨迹才进入可复用资产池。”
引用来源:第二届数据智能论坛——构建智能体的数据基座|2026-10-23 下午|报告题目:《CyberOS—构建 Agent Ready 的 AI 操作系统》 · 论坛日程
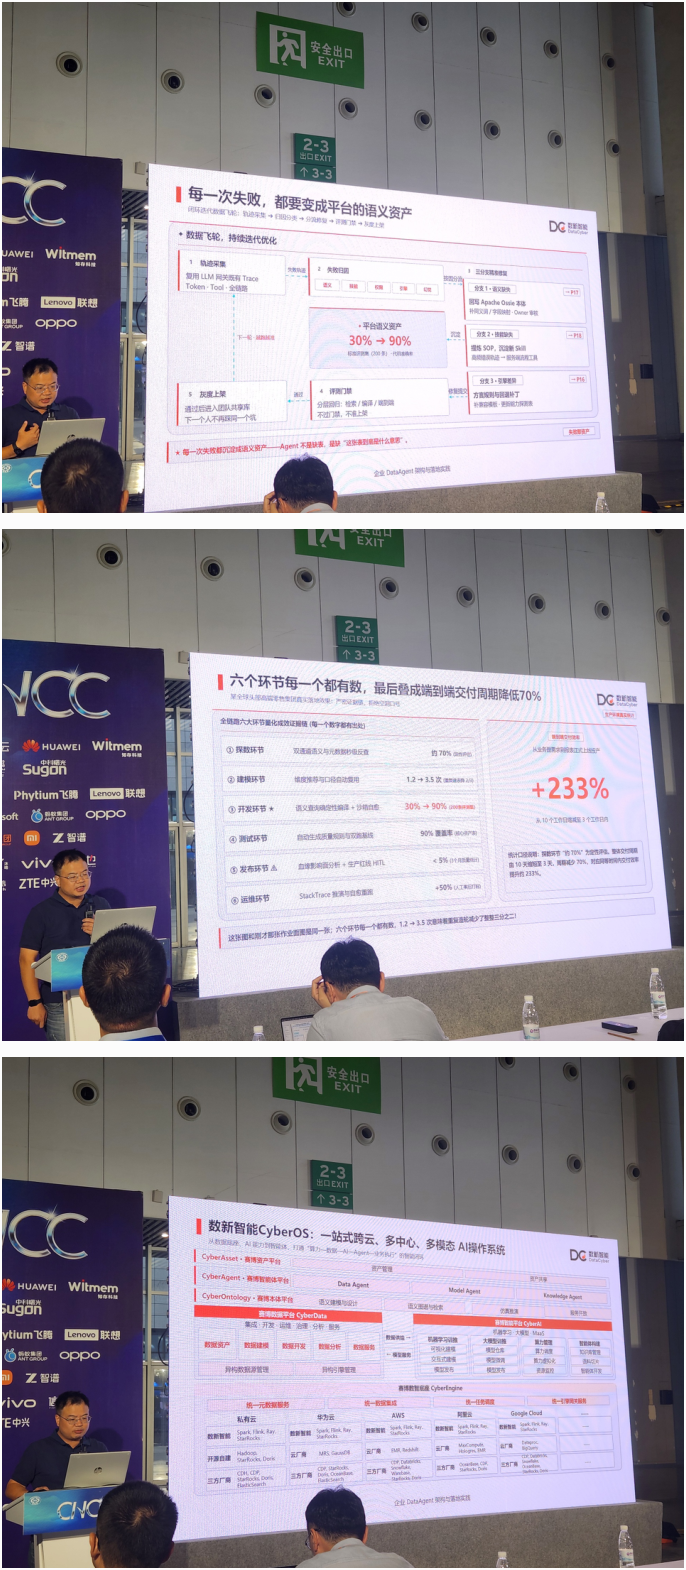
企业数据智能交付:从搜索式 Top-K,转为数据库式精确与私有语义正确。
清华大学计算机科学与技术系长聘副教授
NL2SQL 验收需要语义等价与 query-plan 覆盖——不是字符串匹配或单次执行结果相同
“数据科学智能体面对的是接近数据库式的精确预期,不能沿用搜索引擎「结果列表里大概有一个对」的标准。”
引用来源:第二届数据智能论坛——构建智能体的数据基座|2026-10-23 下午|报告题目:《智能体时代的数据科学系统》 · 论坛日程
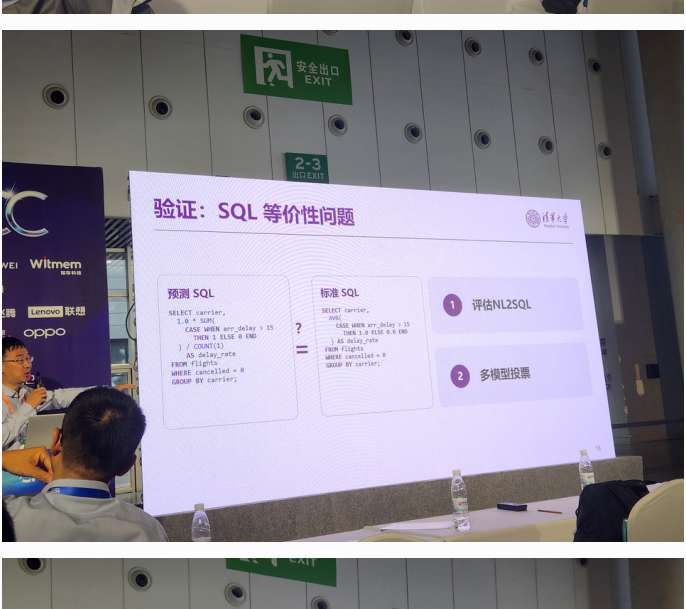
北京邮电大学计算机学院教授
领域抽取须把样本边界与物理约束编码为可执行检查;JSON/Schema 合规不等于领域正确
“样本边界模糊——同一成分可能对应不同处理状态,需要区分样本,再关联各自的属性。……对于结构正确仍然存在事实错误的问题,要引入物理学的领域知识……把领域先验封装为代码约束函数做可执行校验。”
引用来源:第二届数据智能论坛——构建智能体的数据基座|2026-10-23 下午|报告题目:《面向材料科学的高质量性能数据集构建及应用》 · 论坛日程
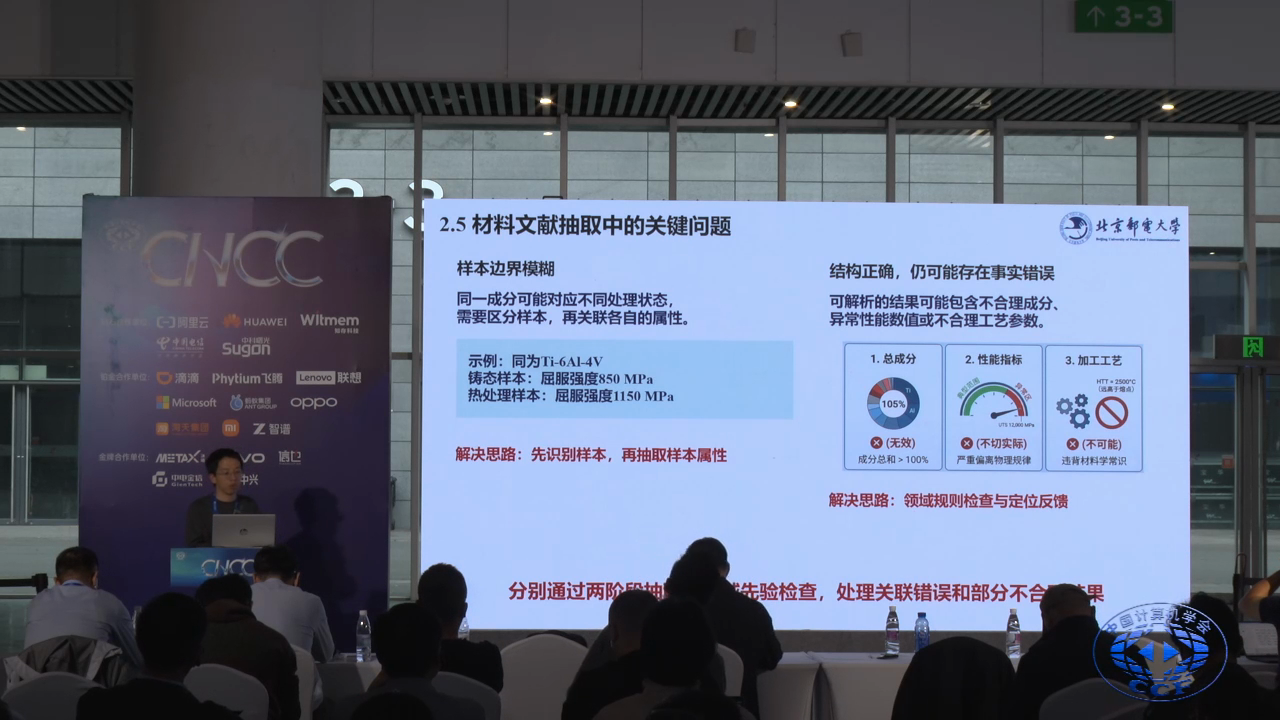
工具数据面:从旧 API 包 MCP,转为语义组织、动态生成和受控执行。
数新智能(DataCyber)CEO
企业 Agent Ready 工具应从人工逐 API 配置转向语义组织、动态生成与受控执行
“原始失败日志还不是资产;只有走过归因、处置、评测门禁和灰度上架,轨迹才进入可复用资产池。”
引用来源:第二届数据智能论坛——构建智能体的数据基座|2026-10-23 下午|报告题目:《CyberOS—构建 Agent Ready 的 AI 操作系统》 · 论坛日程
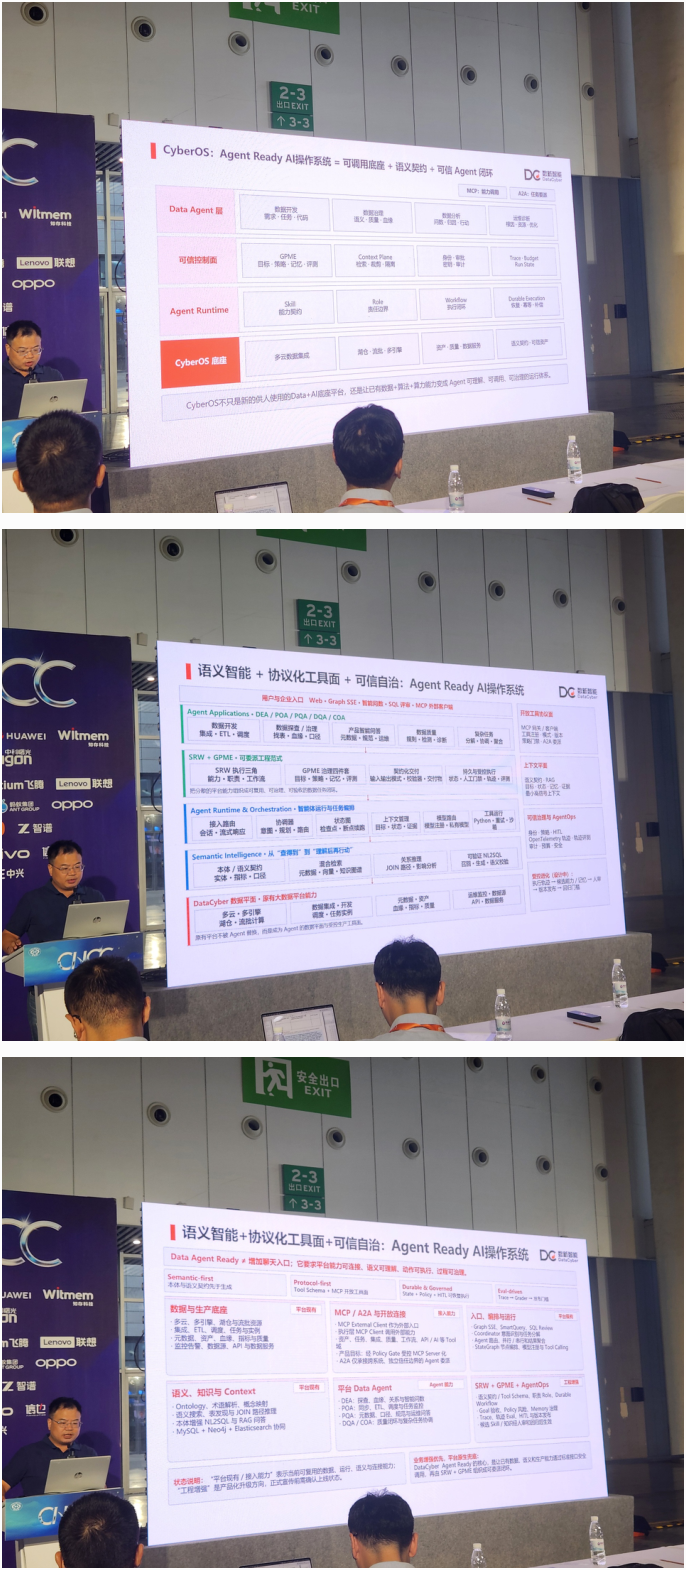
物理智能持续进化:从把世界模型当低成本练习场,转向用真机意外同步修订策略与世界模型并沉淀经验。
香港科技大学计算机系讲座教授;港科大物理 AI 中心主任
持续物理进化的最小闭环:用真机意外同时修订策略与世界模型,并沉淀可复用经验
“持续的进化就是说我不仅……要根据策略模型……还有一个就是说你以前的那个所谓的世界模型,他没有与时俱进,我们也要对他进行一个更新。有了这样的一个持续的一个进化以后,我们就可以让真正的成功留给下一次任务。——用真机意外同时修订策略与世界模型。”
引用来源:23日上午大会特邀报告|2026-10-23 上午|报告题目:《迈向自主进化的物理智能》 · CNCC2026官网
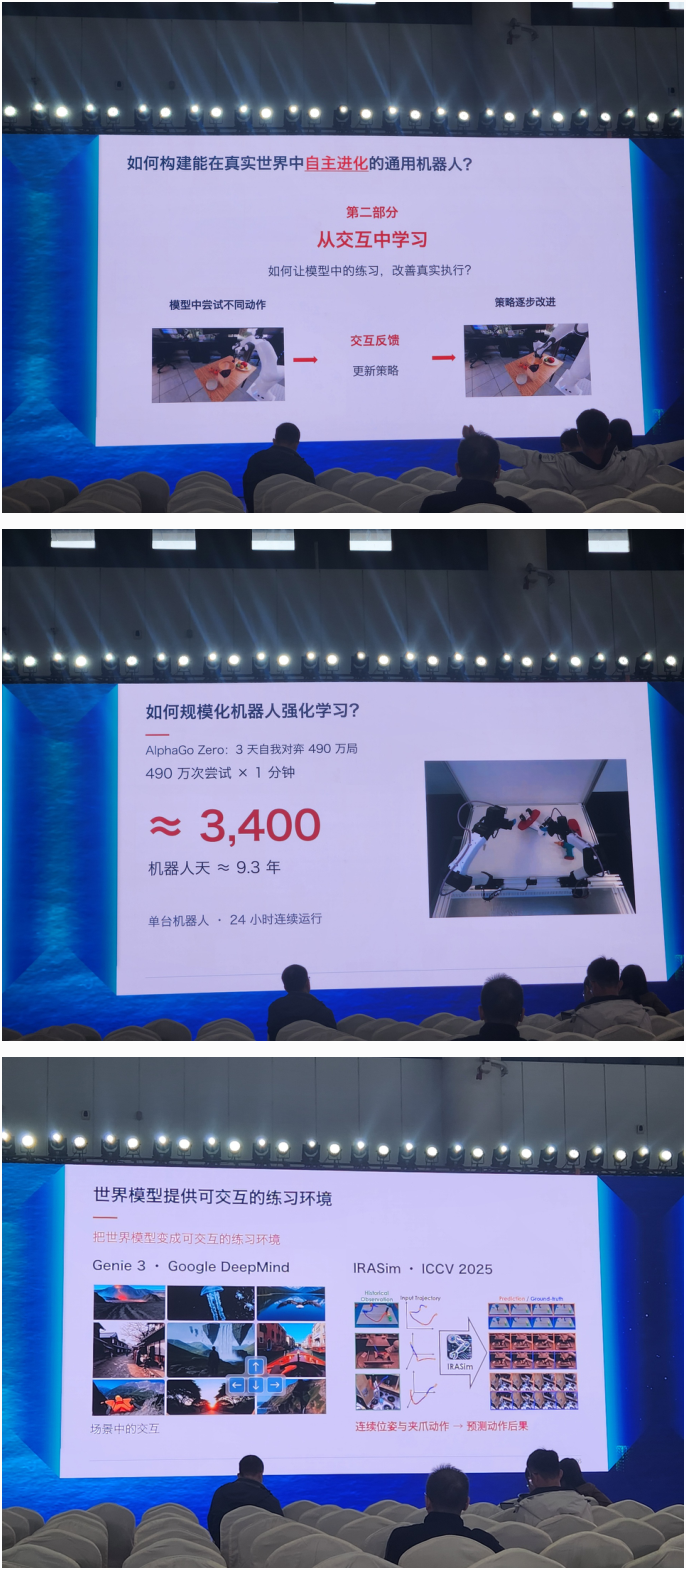
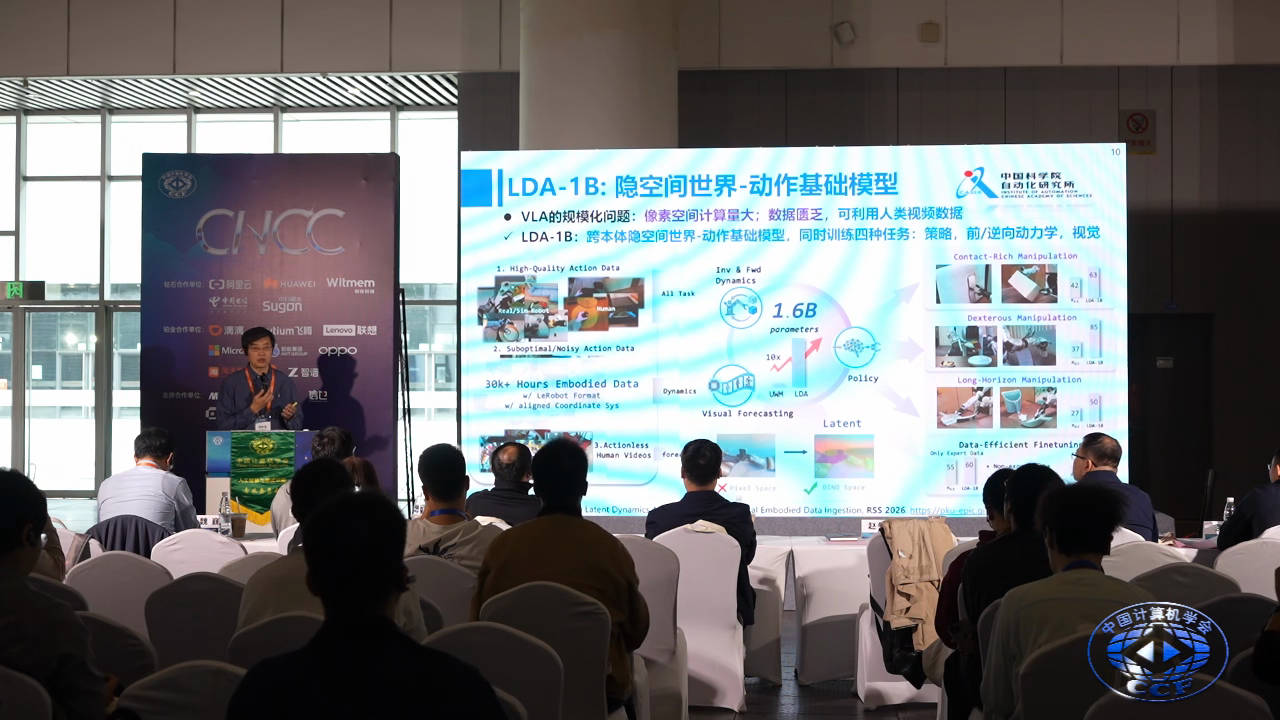
视频动作学习里 latent action 与动作光流是不同假设——视频先验不等于接触力与精细执行。
中国科学院自动化研究所;IEEE Fellow
动作条件世界模型在 VLA 训练前需要阶段级真机校正;视觉生成成功不等于物理任务完成
“仿真环境刷榜刷的高,但实际应用的话还有一个 sim-to-real 的 gap……LDA-1B:跨本体隐空间世界-动作基础模型,同时训练策略、前/逆向动力学、视觉。”
引用来源:第三届多智能体协同与博弈:具身多智能体论坛|2026-10-23 下午|报告题目:《机器人具身智能—训练方法 / 基于世界模型的多智能体强化学习(多题页;按CP选页)》 · 论坛日程
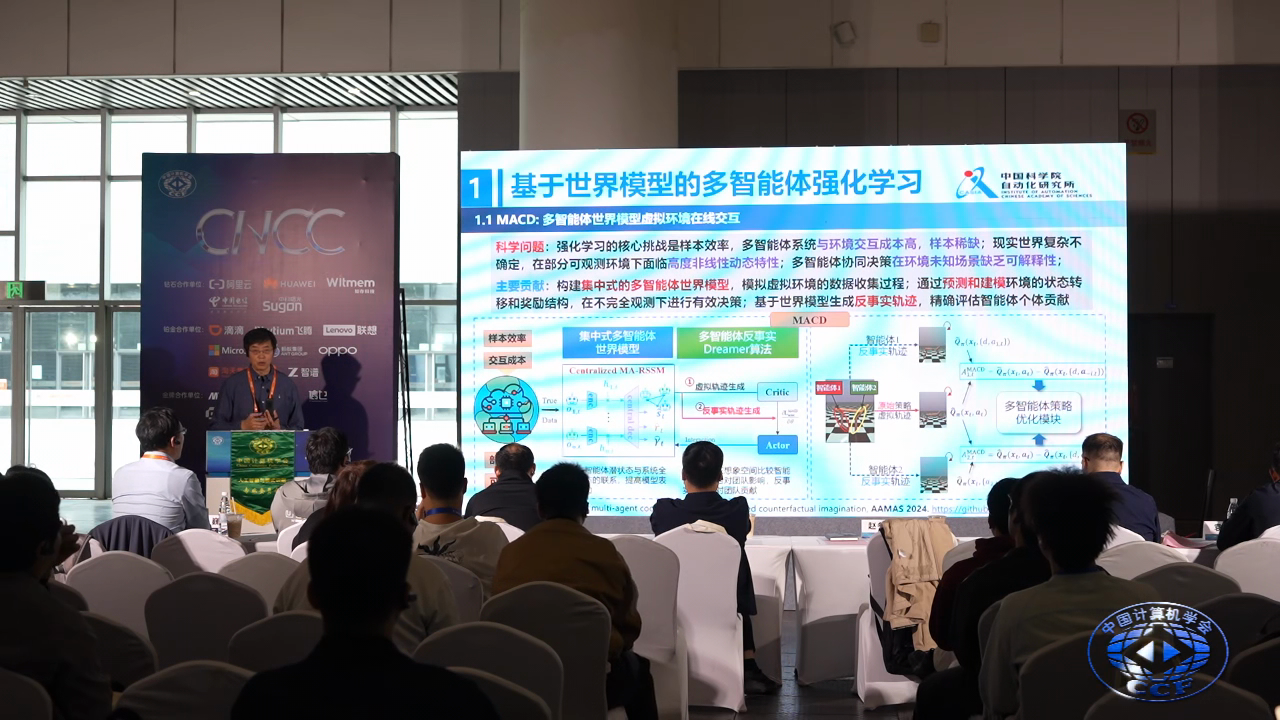
多智能体研究单位:从团队总分,转向反事实信用、顺序推演与规模曲线。
中国科学院自动化研究所;IEEE Fellow
多体信用可通过反事实替换单体动作放入世界模型 rollout
“基于世界模型生成反事实轨迹,精确评估智能体个体贡献……MACD:多智能体世界模型虚拟环境在线交互。”
引用来源:第三届多智能体协同与博弈:具身多智能体论坛|2026-10-23 下午|报告题目:《机器人具身智能—训练方法 / 基于世界模型的多智能体强化学习(多题页;按CP选页)》 · 论坛日程
神经形态/存算硬件定位:从“世界模型”概念标签,转向低功耗、实时、端侧与在线物理闭环。
黄铁军:北京大学计算机学院教授;许晓欣:中国科学院微电子研究所研究员
可辩护的神经形态应用边界是低功耗、实时、端侧、在线物理闭环——而不是“世界模型”这个名词
“世界模型相对语言模型,计算量至少是四个数量级的差别;实时、低功耗、端侧物理闭环才是可辩护的神经形态边界。”
引用来源:第七届神经形态计算:世界模型算法与算力论坛|2026-10-24 下午|报告题目:《神经形态应用边界:低功耗、实时、端侧与在线物理闭环》 · 论坛日程
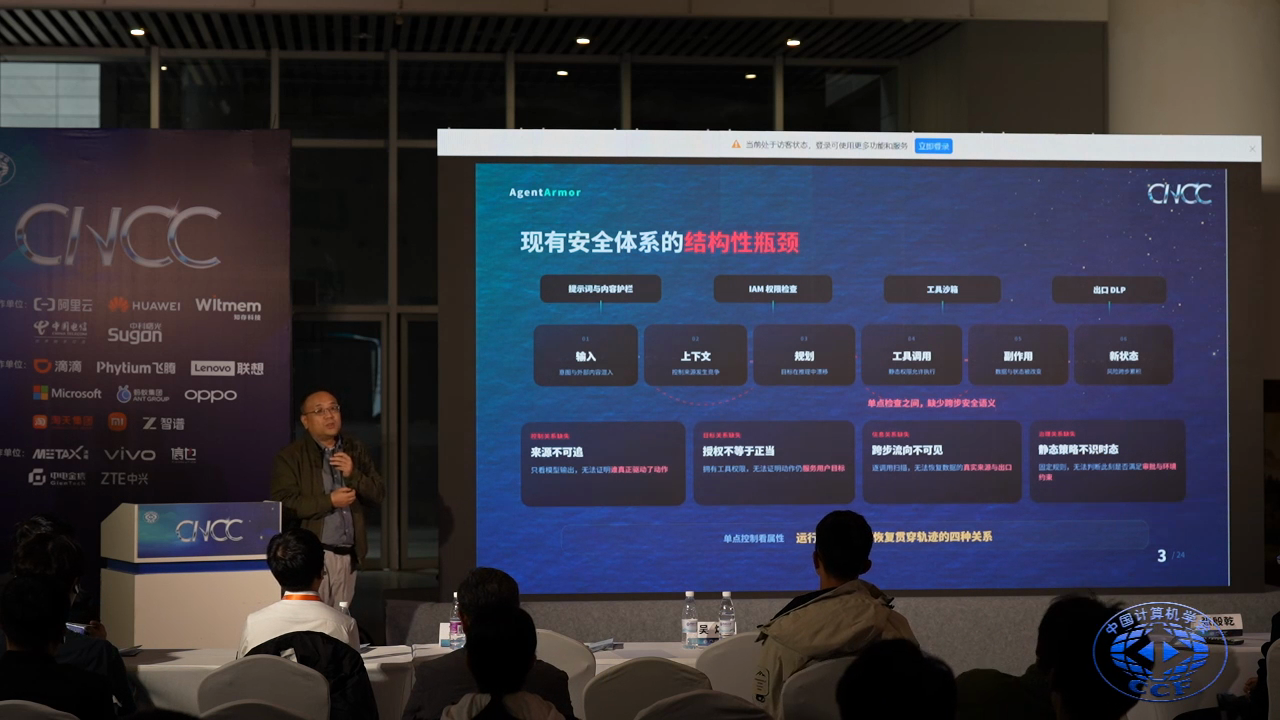
Agent 安全:从检查最终文本和单步 API,转向逐动作重判控制来源、目标、数据流与治理条件。
字节跳动安全研究团队负责人;西安电子科技大学兼职教授、博士生导师
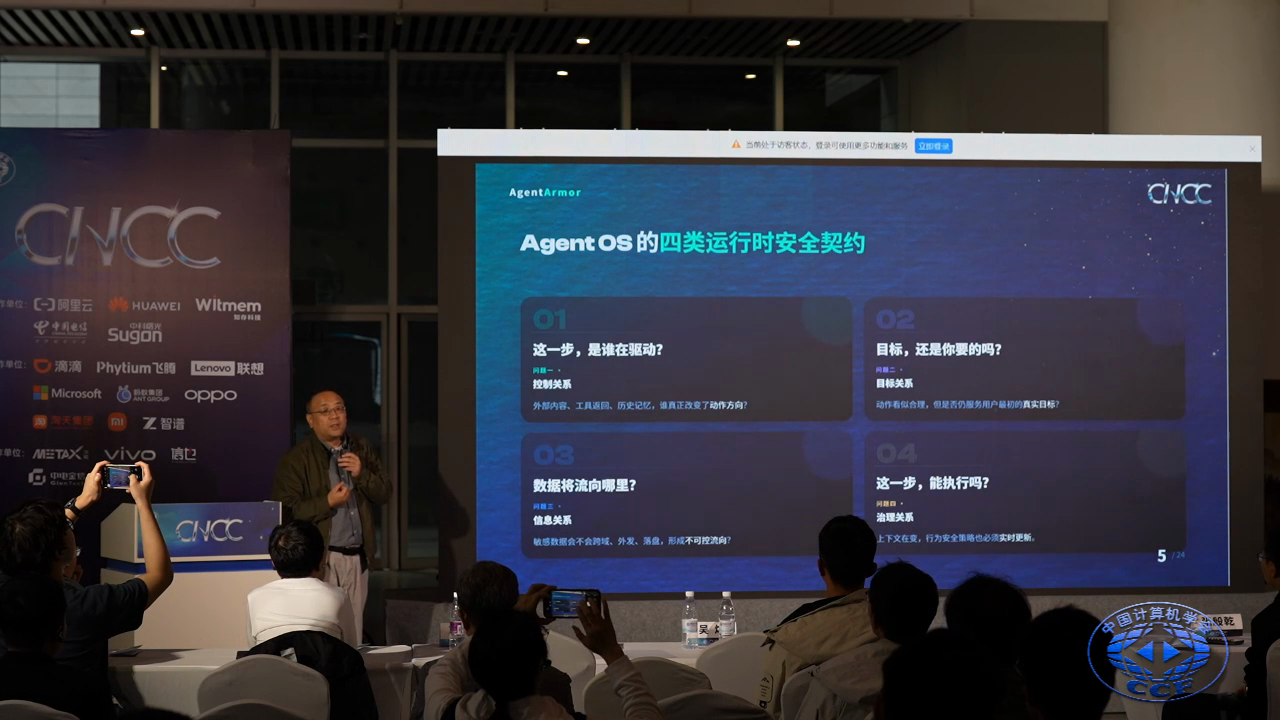
“已经授权”不是安全结论;每个动作须沿控制来源、目标、数据流与动态治理条件重判
“AgentOS 的四类运行时安全契约:控制关系——这一步是谁在驱动?目标关系——还是你要的吗?信息关系——数据将流向哪里?治理关系——上下文在变,行为安全策略也必须实时更新。”
引用来源:驾驭智能体系统Agent OS 的安全困境与信任重塑论坛|2026-10-24 下午|报告题目:《Agent Armor:Agent OS 运行时安全切面》 · 论坛日程
复旦大学;长江学者
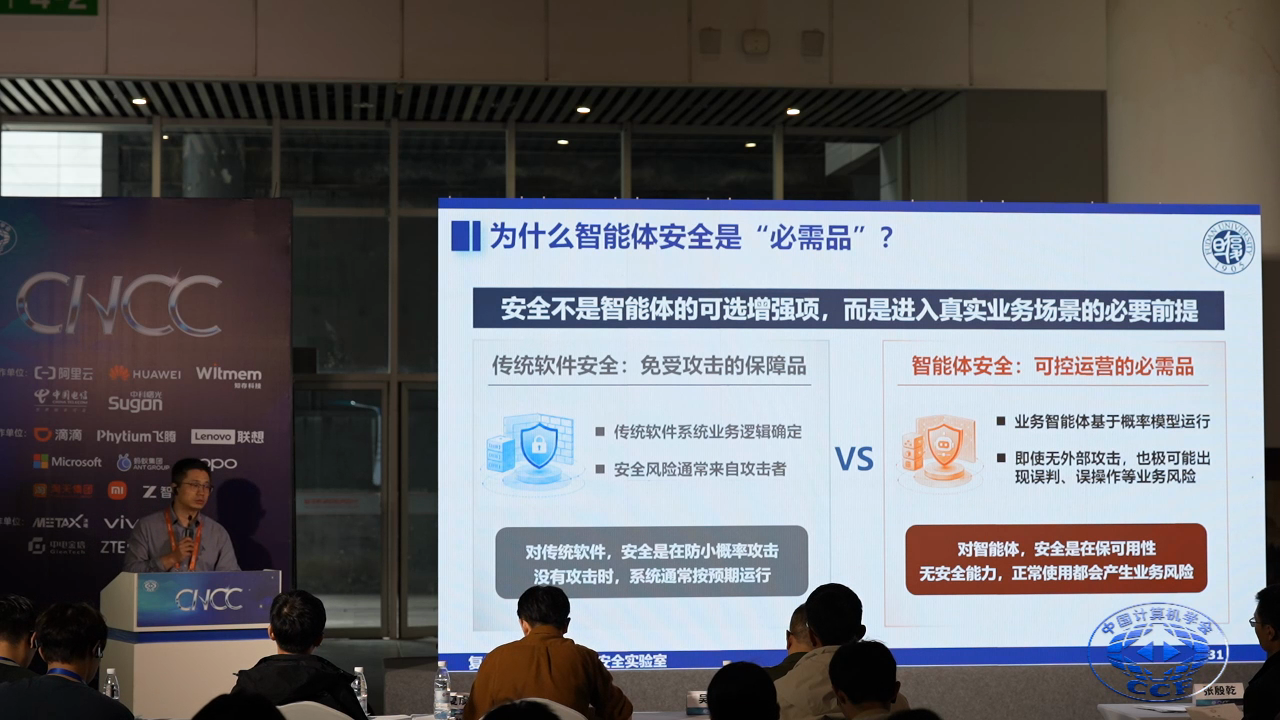
Agent 漏洞发现必须同时穿过模型语义与代码路径,并以动态 PoC 确认;静态扫描不够
“为什么智能体安全是“必需品”?……对智能体,安全是在保可用性——无安全能力,正常使用都会产生业务风险。”
引用来源:驾驭智能体系统Agent OS 的安全困境与信任重塑论坛|2026-10-24 下午|报告题目:《智能体安全风险与防护》 · 论坛日程
Agent 授权:从静态角色或 Skill 总权限包,转向当前上下文最小权限与逐动作持续验证。
字节跳动安全研究团队负责人;西安电子科技大学兼职教授、博士生导师
“已经授权”不是安全结论;每个动作须沿控制来源、目标、数据流与动态治理条件重判
“AgentOS 的四类运行时安全契约:控制关系——这一步是谁在驱动?目标关系——还是你要的吗?信息关系——数据将流向哪里?治理关系——上下文在变,行为安全策略也必须实时更新。”
引用来源:驾驭智能体系统Agent OS 的安全困境与信任重塑论坛|2026-10-24 下午|报告题目:《Agent Armor:Agent OS 运行时安全切面》 · 论坛日程
数据防泄漏:从识别出口内容,转向追踪跨变换血缘与出口可达性,并保留可信降级依据。
字节跳动安全研究团队负责人;西安电子科技大学兼职教授、博士生导师
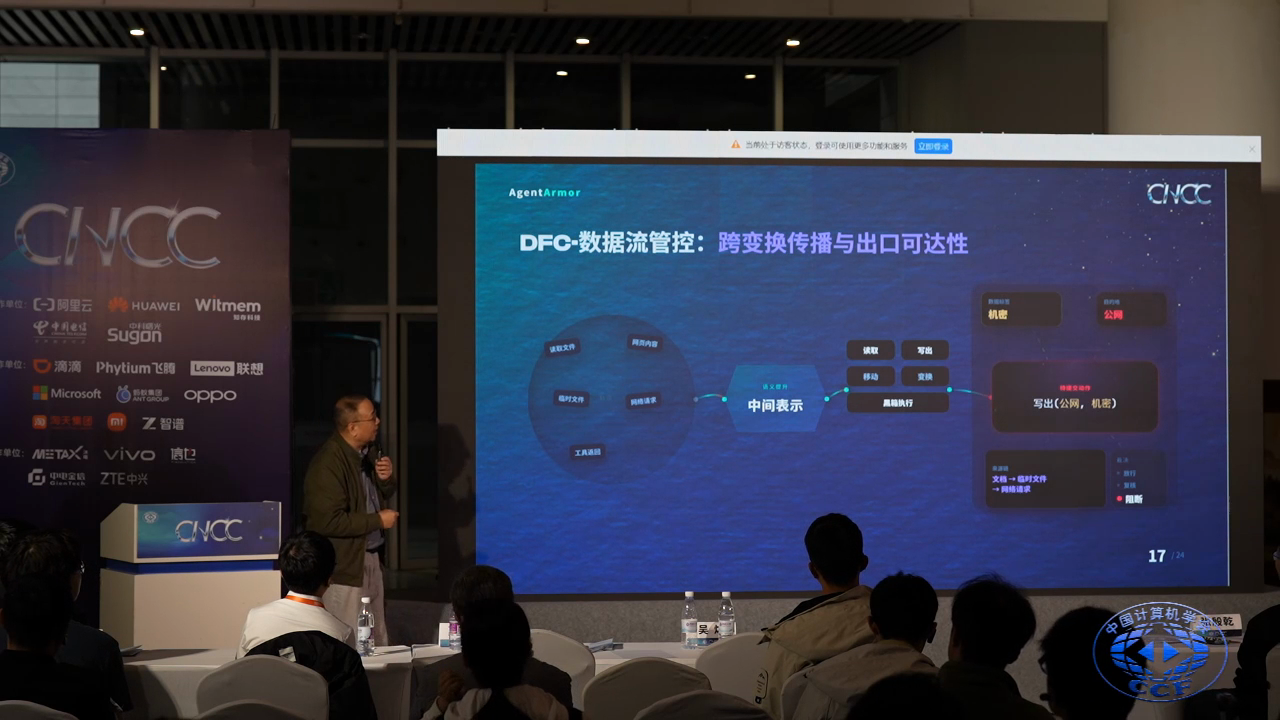
有效的数据防泄漏要跟踪跨变换血缘与出口可达性,同时允许可信降级
“DFC—数据流管控:跨变换传播与出口可达性……跟踪读取/移动/写出等变换后的机密是否仍可达公网出口。”
引用来源:驾驭智能体系统Agent OS 的安全困境与信任重塑论坛|2026-10-24 下午|报告题目:《Agent Armor:Agent OS 运行时安全切面》 · 论坛日程
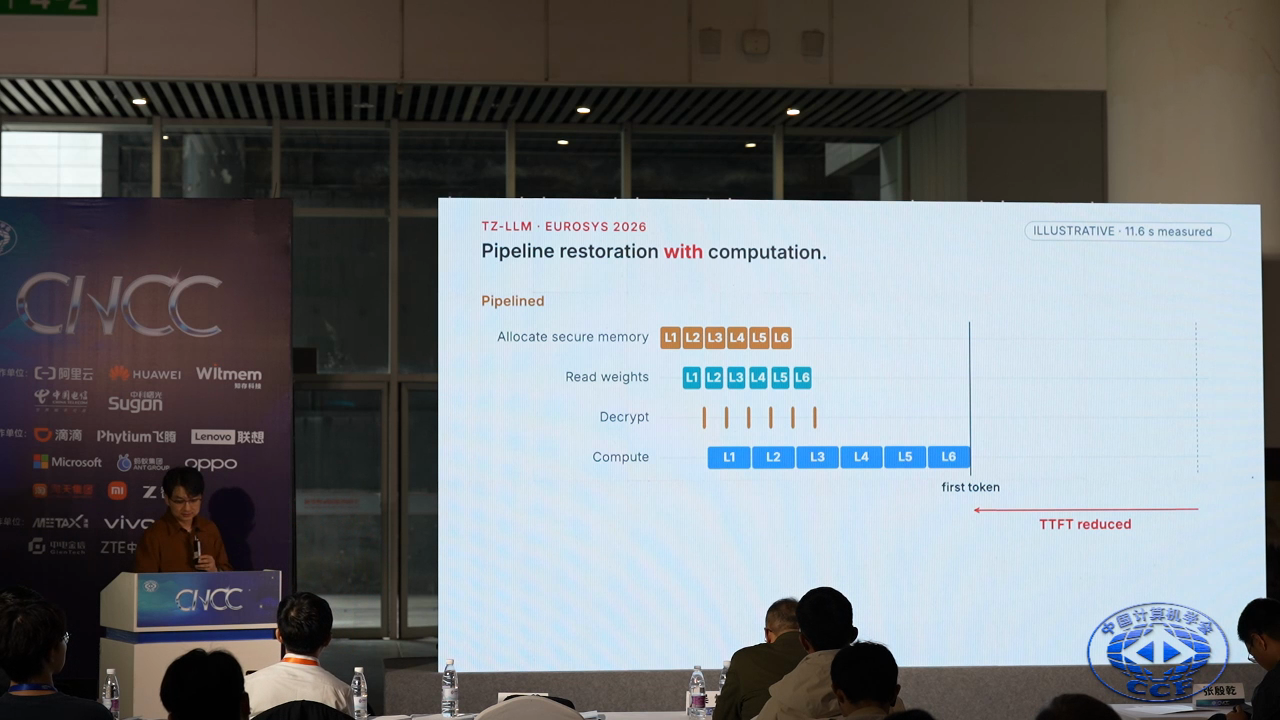
端侧 TEE 设计:从把 TEE 当模型保险箱,转向明确保护范围、缩小可信基并管住 I/O 边界。
上海交通大学计算机学院教授
可信端侧推理工程应缩小 TCB 并隐藏安全加载成本——把完整 NPU 驱动搬进 TEE 通常不是正解
“Pipeline restoration with computation:Allocate secure memory → Read weights → Decrypt → compute……TTFT reduced.”
引用来源:驾驭智能体系统Agent OS 的安全困境与信任重塑论坛|2026-10-24 下午|报告题目:《智能体操作系统与安全》 · 论坛日程
Agent 行动归因:从可复用账号,转向委托—驱动—审批—执行的当次证据链。
陈启军:华为计算产品线
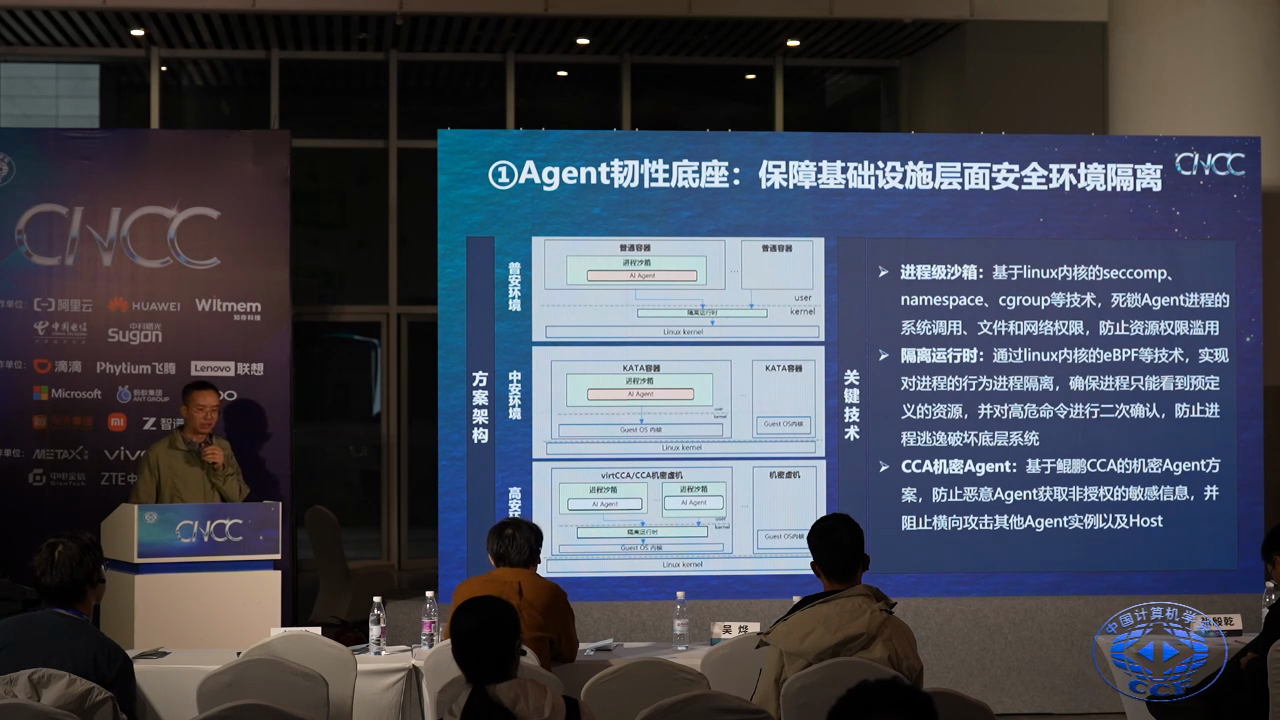
无法绑定本轮委托、运行时实例、责任方、授权上下文与实际 syscall 的 Agent 身份,解决的是登录问题而非行动归因
“进程级沙箱:基于 linux 内核的 seccomp、namespace、cgroup 等技术,死锁 Agent 进程的系统调用、文件和网络权限……CCA 机密 Agent:防止恶意 Agent 获取非授权敏感信息。”
引用来源:驾驭智能体系统Agent OS 的安全困境与信任重塑论坛|2026-10-24 下午|报告题目:《基于鲲鹏计算的 Agent 安全解决方案实践》 · 论坛日程
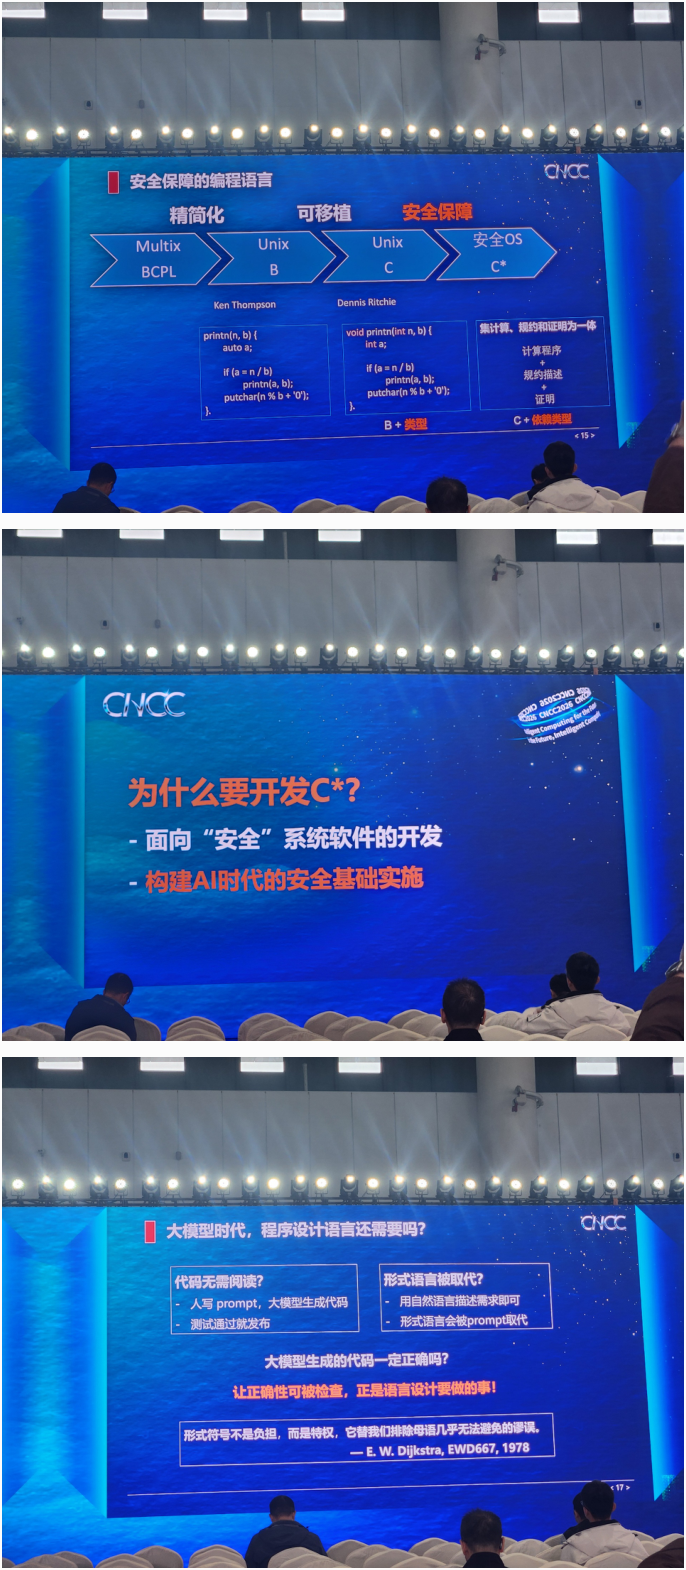
AI 代码生成:从只扩大代码产能,转向代码、合约与机器可检查证明一并交付。
北京大学计算机学院院长、讲席教授
AI 可扩大代码与证明产能,但正确性仍需要机器可检查的合约与证明
“AI 可以放大代码与证明的产能,但正确性最终仍要落在机器可检查的合约与证明上。”
引用来源:23日上午大会特邀报告|2026-10-23 上午|报告题目:《面向可信智能系统的安全编程语言:开发与证明一体化的路径与实践》 · CNCC2026官网
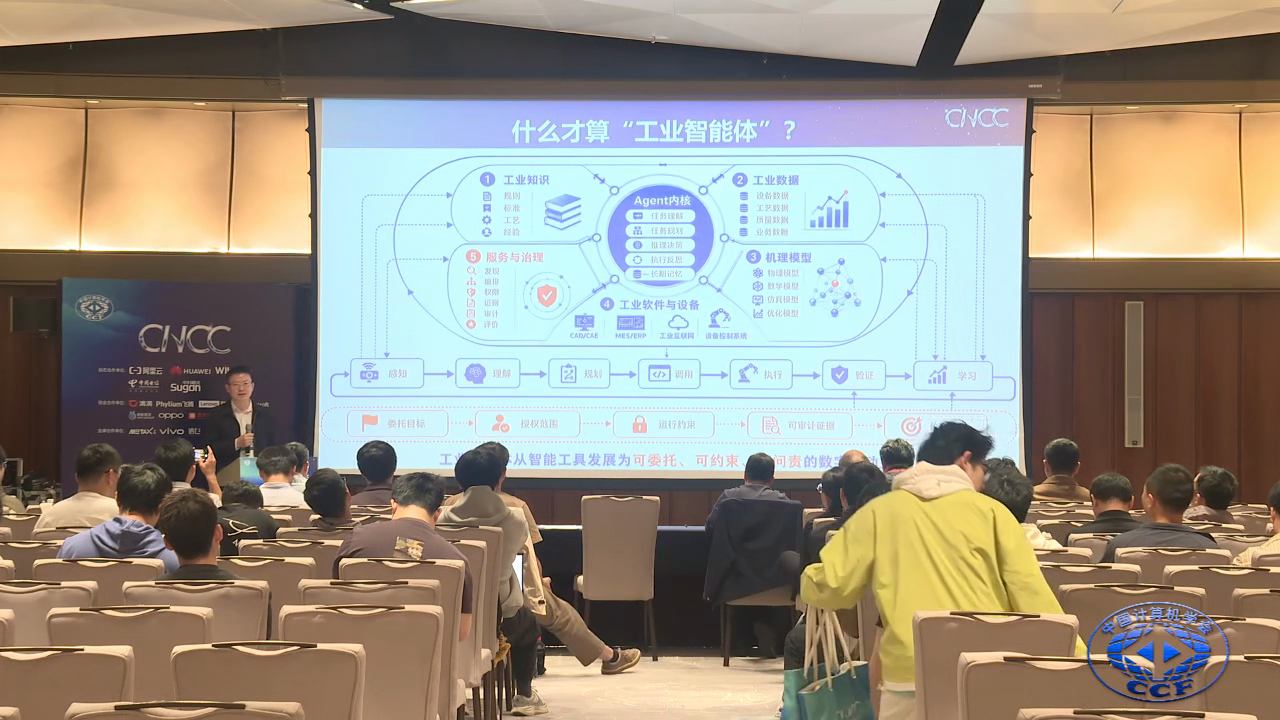
工业 Agent 栈位:从替代专业求解器和业务账本,转向存量工程软件之外的可审计闭环编排层。
王忠杰:哈尔滨工业大学教授;刘智慧:同元软件总经理
工业 Agent 应作为 MBSE/CAD/CAE/MES/ERP 之外的可审计闭环层——而不是替换求解器、数据与责任账本
“什么才算“工业智能体”?……从智能工具发展为可委托、可约束、可审计证据、可问责的主体……对接工业软件与设备 / 工业数据 / 机理模型,而不是替换求解器与责任账本。”
引用来源:第二届工业智能论坛:工业智能体理论与系统|2026-10-23 下午|报告题目:《工业智能体——发展态势、科学问题与前沿探索 / 系统计算仿真工业软件与装备工程智能体》 · 论坛日程
工业预测产品:从交付准确率,转向预测、决策、执行与结算的滚动闭环,并以净收益验收。
华东理工大学教授;杰青
预测性维护与能源预测的价值在执行与结算闭环;精度提升若不改善净收益/SOH/停机,就不构成产品价值
“预测—调度—交易—维护要做成一体化;精度提升若换不来净收益、SOH 或停机改善,就不构成产品价值。”
引用来源:第二届工业智能论坛:工业智能体理论与系统|2026-10-23 下午|报告题目:《源网荷储协同调度与预测性维护技术》 · 论坛日程
工业 AI Ready Data:关键苦功从运行时反复搜索,转向离线业务对象与关系组织。
清华大学大数据系统软件国家工程研究中心总工程师
复杂工业追溯应先离线组织 BOM—工序—订单—质量—保修对象;运行时 Agentic RAG 不能替代数据治理
“核心问题不是模型能做什么,而是高风险决策里我们不敢放心让它做什么。”
引用来源:第二届工业智能论坛:工业智能体理论与系统|2026-10-23 下午|报告题目:《面向智能体的 AI Ready Data 体系构建》 · 论坛日程
极端边缘:从搬模型与回传整包,转向在数据产生处交付任务答案;绿电把能源波动传导为计算与网络调度。
东北大学教授;杰青
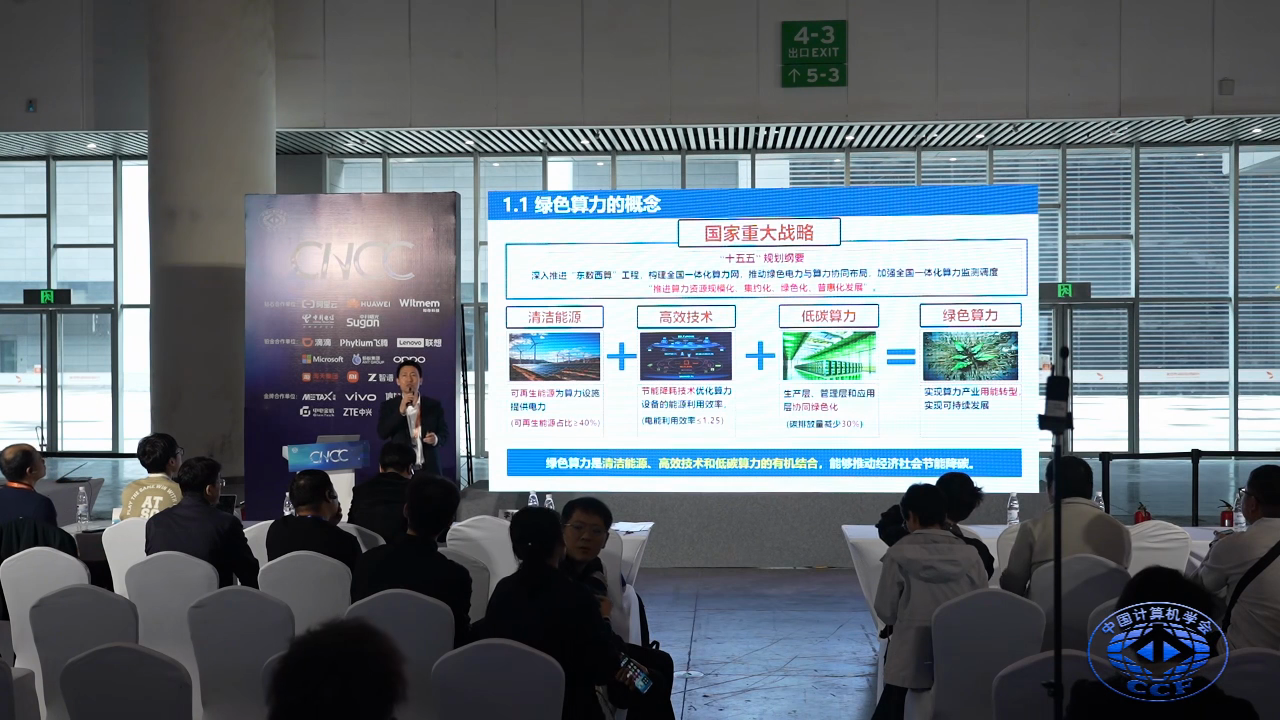
绿色算力调度应先服从电力可行性,再按任务类型、deadline、储能退化与迁移成本扩大调度域
“绿色算力是清洁能源、高效技术……深入推进“东数西算”,推动绿色电力与算力协同布局。……打造绿色算力,其实……能源技术的发展与算力技术紧紧绑定在一起。”
引用来源:第四届边缘智能技术论坛|2026-10-24 下午|报告题目:《绿色算力关键技术及大模型调度》 · 论坛日程
上海交通大学
极端边缘要把数据在产生处算成可回传的短答案,而不是把高清载荷整包拉回地面。
“我们现在选的就是第二条路,来发展星上的智能计算。把这些本来要落到地面上的数据,我们在卫星上就直接通过智能计算把它分析出来。得到了结果之后把它变成短消息,短消息要发回来就容易了。”
引用来源:第四届边缘智能技术论坛|2026-10-24 下午|报告题目:《智能红外卫星的关键技术》 · 论坛日程
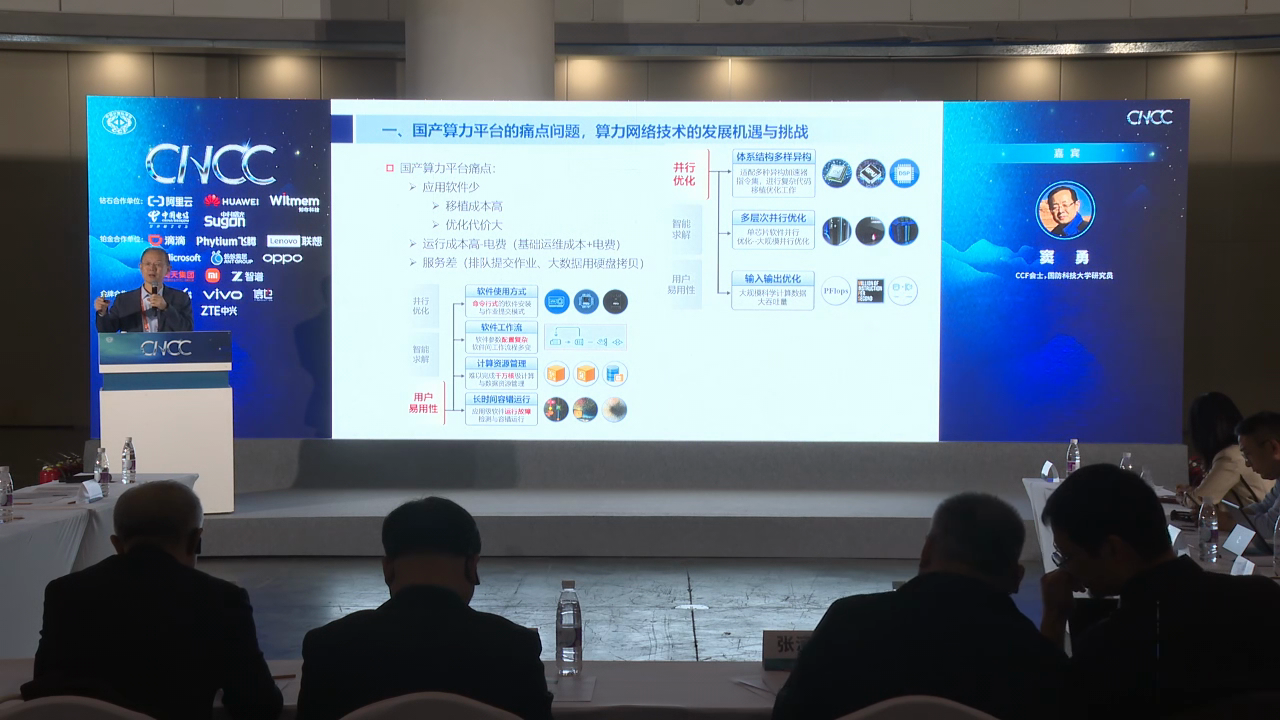
网算服务竞争:从资源可连接与堆硬件,转向软件优化深度和订单式交付,多模型路由须逐跳证明知识增量。
国防科技大学计算机学院研究员、博士生导师;杰青
国产加速器采用瓶颈可能先落在软件优化深度与订单式服务体验,而不是继续堆硬件
“从学术研究来讲,我希望以后我们的软件能做到这种程度——现在体验的(弹性/订单式)服务。”
引用来源:第三届智能网络与网算融合论坛|2026-10-24 下午|报告题目:《应用场景牵引算力网络技术发展》 · 论坛日程
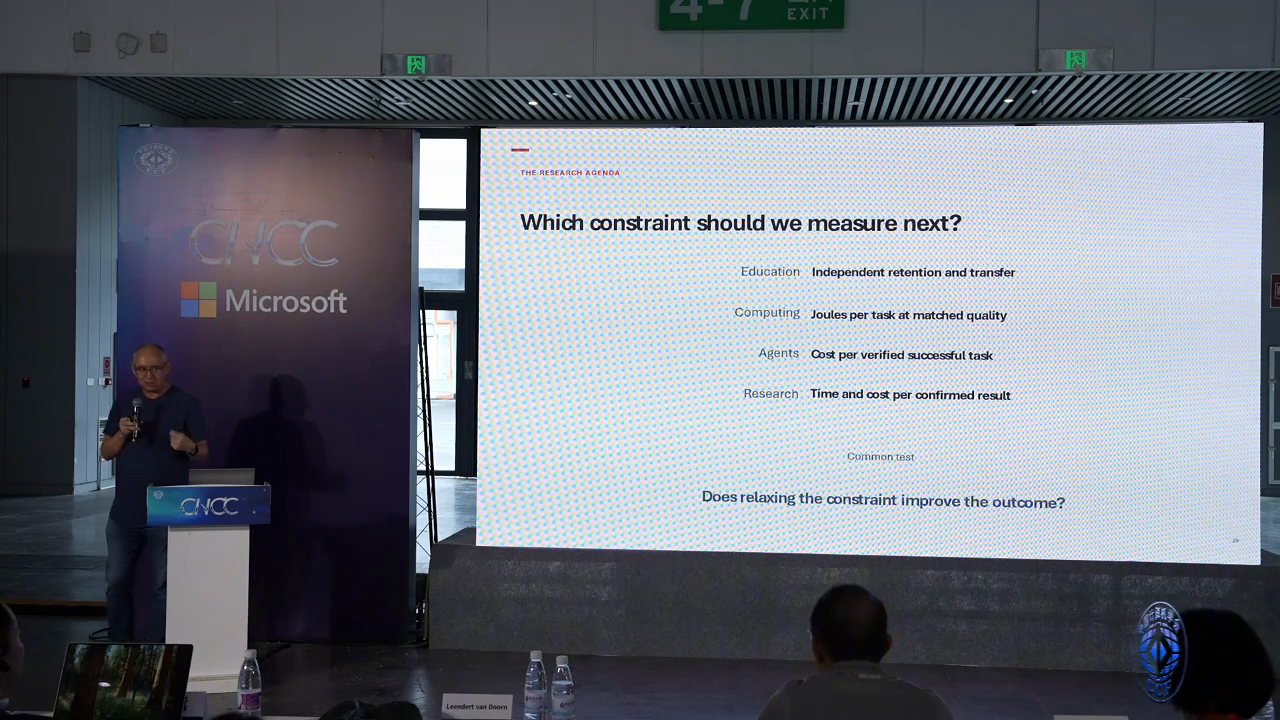
AI4S 与软件工程:从生成产出,转向验证、可检验实验和失败回流的连续反馈。
前 Qualcomm 高级副总裁
AI4S / 软件验证连续反馈链
“Generation becomes cheap; judgment / feedback / verification become scarce. Same pattern for AI for science: good at generating possibilities, then someone needs to test it. For agents: cost per verified successful task.”
引用来源:AI for Research & Education 论坛|2026-10-24 下午|报告题目:《Uncomfortable Questions for the AI Era》 · 论坛日程
四川大学计算机学院教授
虚拟细胞要能预演扰动响应并提出可检验的下一步实验,而不只是拟合已有观测。
“既然实验不可能遍历所有组合,能不能从已有观测里学习可复用的规律,去预测尚未做过的实验?虚拟细胞有望在计算机当中预演大量生物学实验,并持续调整实验优先级。”
引用来源:第三届科学智能AI4S:科学智能与社会智能论坛|2026-10-22 下午|报告题目:《虚拟细胞:AI 驱动的生命模拟》 · 论坛日程
阿里巴巴 ATH 副总裁(千问事业部算法技术)
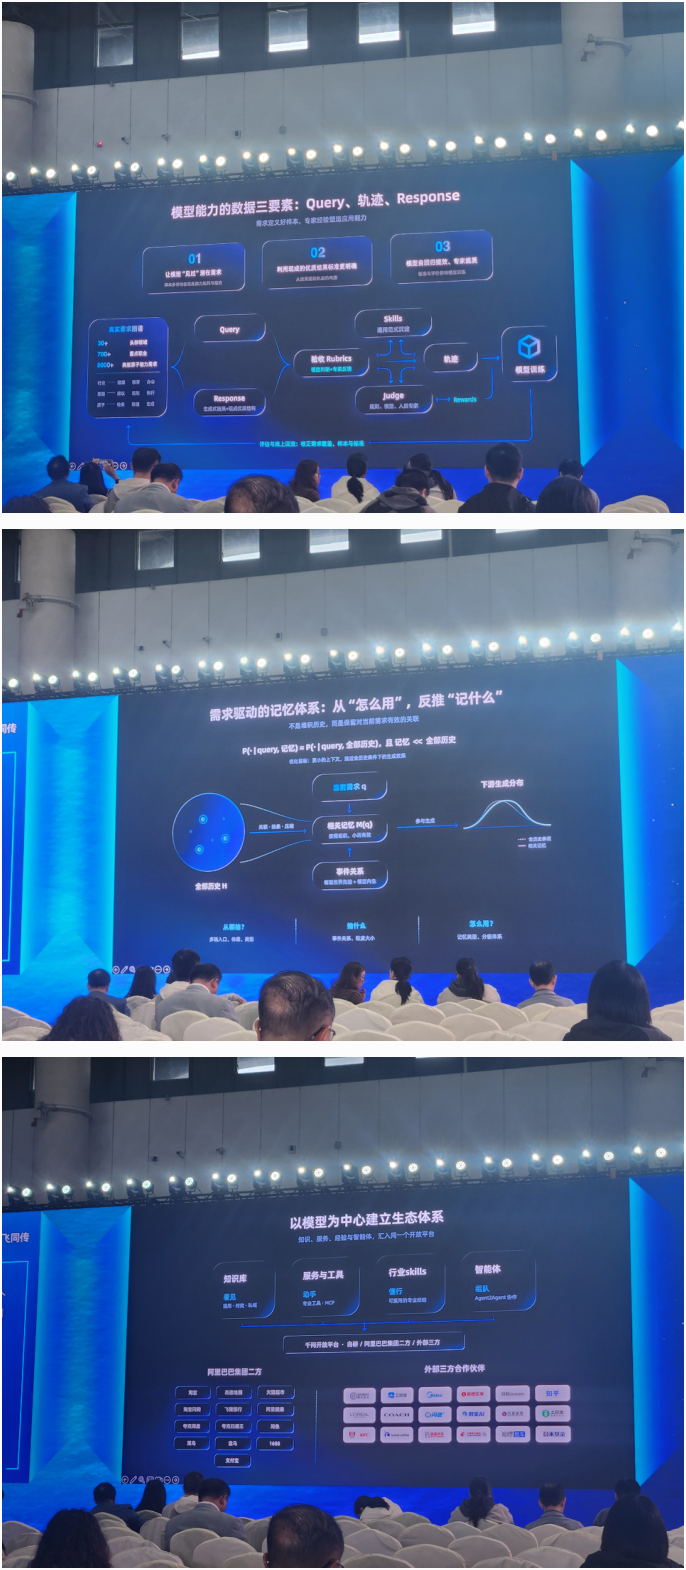
Personal Agent 的下限稳定性来自需求—rubric—专家轨迹—线上失败回流,而不是发布会峰值能力或单纯扩模型(产品/入口层,非 AgentOS 主线)(次要反馈环)
“我们相信AI的终局一定是personal agent。……千万去整理了全行业的各类需求和问题,从回复结果出发去寻求有路径的解决路径的一个最优解……尽量通过工具和skill这样的这些专家经验去用生态的能力去解决……当碰到一个新问题它失败的时候,其实模型可以通过它的冗余能力去对问题做更好的回溯和重新的规划。”
引用来源:22日上午大会特邀报告|2026-10-22 上午|报告题目:《千问 Personal Agent 实践》 · CNCC2026官网
遗留软件 Agent:从以 token 价格和生成速度估算 ROI,转向按经验证成功任务成本衡量反馈链改造。
前 Qualcomm 高级副总裁
企业 Agent 应按每个经验证成功任务的成本计分;遗留增量构建、测试映射、缓存与规格完成度往往比 codegen 速度更决定 ROI
“When generation gets cheap, judgment, verification, feedback loops and energy become the scarce resources.”
引用来源:AI for Research & Education 论坛|2026-10-24 下午|报告题目:《Uncomfortable Questions for the AI Era》 · 论坛日程
科研评价:从论文产量与表面新颖性,转向可验证性、研究多样性与真实迁移。
香港科技大学计算机系讲座教授;港科大物理 AI 中心主任
AI 加速出题与发表之后,研究多样性与可验证迁移成为稀缺;产量上升不等于主题面扩张。
“Significance and originality with AI already look strong; exploitation and diversity nowadays are not that promising — papers can triple while the scope stays narrow.”
引用来源:AI for Research & Education 论坛|2026-10-24 下午|报告题目:《When Solving Gets Cheap: From Accelerating Discovery to Developing Researchers》 · 论坛日程
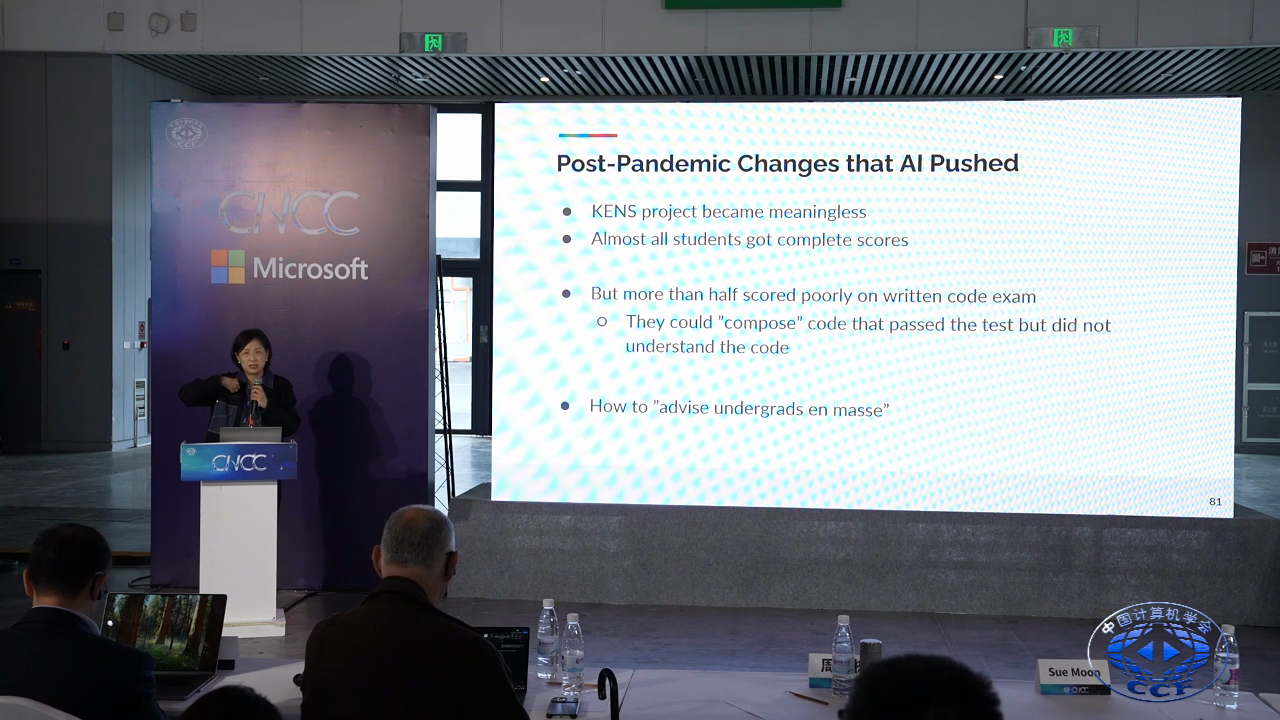
教育与招聘:从单看 AI 协作产物,转向协作交付加无工具独立解释与迁移的双轨评价。
KAIST School of Computing 教授;KIISE 会长
通过 AI 辅助项目不等于证明理解;教育与招聘需要双轨——AI 可完成的真实任务,加上无工具的解释/填空/迁移
“Almost all students got complete scores. But more than half scored poorly on written code exam. They could "compose" code that passed the test but did not understand the code.”
引用来源:AI for Research & Education 论坛|2026-10-24 下午|报告题目:《从大学教育转向韩国 K-Education——AI 冲击下的课程、课堂与“Great Reset”》 · 论坛日程